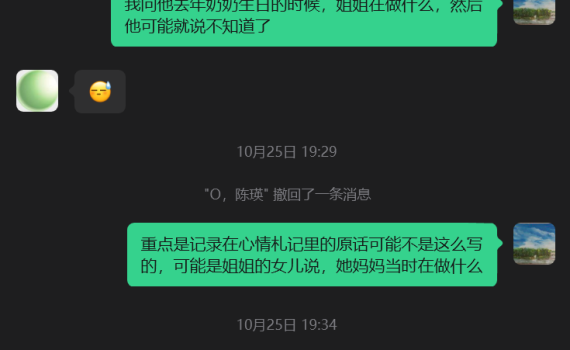
1. 概述 前两天有一个 陈ying 大佬(他跟我一样,也在自己做一个与XiaoMATE类似的、复刻数字版本全记忆的自己的数字人)在微信上私信聊起关于个人助手及记忆的事情,后来聊天如何做好个人的记忆的问题上,其中很大一个点就在于心情札记(https://mp.weixin.qq.com/s/lI5nASpTs6EtSiJKaSBz7A)中的人物关系功能上,这部分也是我前前后后、反反复复一直未能把 XiaoMATE 调教到理想状态的一个关键问题点。 我从历史的心情札记的记录中已经提取出来很多不同的人物以及该人物与我的关系,目标中希望做到:“我问他去年奶奶生日的时候,姐姐在做什么”。 但是当我去问一些问题的时候,RAG查询出来的记录结合现有的prompt提示词,返回的结果经常会神一刀、鬼一刀。有一些问题即使在后台RAG召回测试的时候有命中,并且 Rerank 重排序也都正确的筛选出来,但是放到 LLM 返回的时候,组织出来的语言依然不理想,很是头疼。 这个周末在家就再把 XiaoMATE 的RAG功能再整理一下,希望可以再来优化优化。以下是这周的一些实践与尝试。 1.1 个人札记与记忆问答场景 XiaoMATE 的 **Journal(札记)**模块是用户记录日常生活、心情和想法的地方。用户可以随时写下当天的见闻、情绪变化或重要事项,系统会自动从中提取人物(JournalPerson)、组织(JournalOrganization)和人物提及(JournalPersonMention)关系,构建用户的个人记忆图谱。 在后续的语音或文字对话中,用户会自然地基于这些积累的记忆发起提问: 这类问题的共同特点是:需要 AI 从用户长期积累的大量个人数据中,快速、准确地召回相关上下文,再组织成自然语言回答。这正是 **RAG(检索增强生成)**技术在 XiaoMATE 中的核心应用场景。 1.2 场景中遇到的实际问题 在上述札记问答场景中,系统运行暴露出一系列性能和体验问题: 问题一:首次查询延迟过高 当用户积累了几百条札记后,首次触发记忆检索需要从数据库拉取全部数据、逐条计算 Embedding、构建 FAISS 索引,整个过程可能耗时 20~30 秒。在语音对话场景中,用户说完”上次提到的小王是哪个公司的?”后,若需要等待半分钟才能得到回应,交互体验将完全断裂。 问题二:批量导入时的无效计算 用户一次性导入 100 条历史日记,后台自动提取人物和组织信息。此过程会触发数十次数据变更信号。若每次变更都立即重建索引,系统将在后台空转数分钟。而现实情况是,用户导入完数据可能就去忙别的事了,索引建完即被 LRU 淘汰,计算资源被大量浪费。 问题三:重复查询的冗余开销 用户围绕同一话题连续追问时,例如先问”这款产品的保修期是多久?”再问”那维修点在哪?”,每次都要重新执行完整的 Embedding + FAISS + […]
持久记忆
2 posts
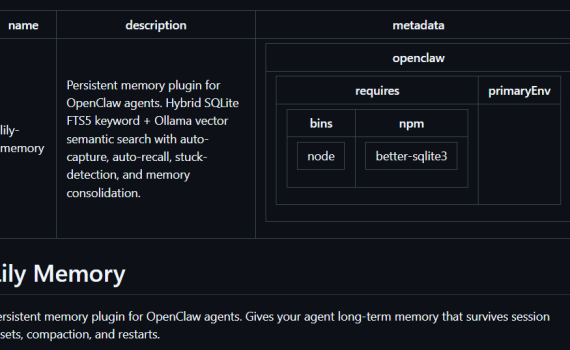
序言 想象这样一个场景:你花了半小时向 AI 助手解释你的项目架构、编码偏好和团队规范,得到了一次满意的协作体验。第二天你带着新问题回来,它却一脸茫然——「请问您的项目使用什么技术栈?」 这不是科幻,这是无数 OpenClaw「养成」过程中最常见的阵痛。 这不是科幻,这是无数 OpenClaw 用户每天都在经历的现实。 「OpenClaw 又忘了!」——这是 GitHub Issue 区最常见的抱怨。就在今年 1 月,一位开发者在 Issue #5429 中诉说了自己的遭遇:他花 45 小时与 Agent 协作积累的配置、技能集成、任务优先级,在一次静默的压缩(compaction)操作后全部消失。原因很简单:OpenClaw 在上下文窗口满载时,会自动对历史对话进行摘要和压缩,而这个过程没有任何警告。 这不是孤例。另一位用户报告说,他正在处理一个重要的代码重构任务,当对话进行到第 72 分钟时,compaction 触发了无限循环,整个 Agent 被锁死了 72 分钟。再重启时,之前的工作成果荡然无存。 本文将带你从痛点出发,遍历官方与社区方案,最终选定 lily-memory 这套「本地化 + 混合搜索 + 零成本」的方案,手把手教你从零养成 OpenClaw 的持久记忆能力。 一、前言:问题本质——三层失效 要理解 OpenClaw 为什么会「失忆」,我们需要理解它的记忆架构。在实际使用中,记忆失效发生在三个层面: 失效层一:从未存储。这是最常见的情况。用户在与 Agent 对话时,会自然地给出一些重要信息:「我习惯用 Tab 缩进」「上次那个 […]