前言 前阵子我用混元3D的图生3D功能给 XiaoMate桌宠 生成一个3D人物模型,但是留了一个大问题,人物模型的纹理都没有了。今天在家折腾了半天,终于在Codex的协助下,把这个问题解决了。 前两天的原文:【XiaoMate】用自己的照片生成一个你自己的3D人物模型https://mp.weixin.qq.com/s/zDCoFOIaghR5ZE0UNQSCdQ 这是今天再次用前两天的照片生成的那个模型,大家可以看看效果如何。 一、问题原因 根据Codex的分析,实际情况是这样的。 Mixamo 并没有删除贴图节点结构 ——材质(Material.001 )里的 Principled BSDF、Normal Map、Image Texture 节点都还在。真正的问题是: 另外,你texture/ 文件夹里只有基础色贴图, 缺少法线贴图和金属粗糙度贴图 ——这两张其实内嵌在原始的original-from-3d-hunyuan.glb 里。 二、解决方案 三、补充说明 以后遇到 Mixamo 丢贴图的情况,通用做法是: 重新把图片路径指回你的贴图文件,然后在导出 FBX 时勾选 “Embed Textures” (或用 Blender 的path_mode='COPY', embed_textures=True ),这样贴图就会内嵌进 FBX,不会再丢。 四、完整流程说明 1. 完整流程 我来把整个流程封装成一个通用的命令行脚本,整个生成3D模型的步骤变成: 2. 配套脚本 参数: 参数 说明 --glb 在混元3D上生成并下载下来的、原始的、带贴图、没有绑定的 .glb(必填) […]
小落同学
12 posts
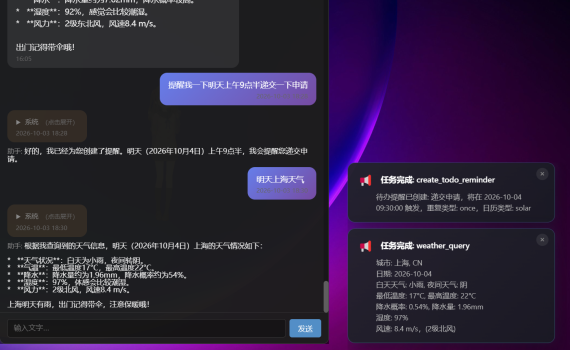
前言 在 9 月 26 日的 v2.0.7 版本中,XiaoMate 完成了 Live2D 与 3D 模型同台运行的核心能力。这个国庆节放假了,我把重心转向了另一个同样重要的方向:聊天交互体验,同时,Live2D点击触控动作也优化了一下,支持点击不同身体部位播放不同的动作和声音(需要Live2D模型的支持),另外,也准备开始支持Windows/MacOS双端构建(缺一台Mac电脑来验证)。 此前,XiaoMate 的聊天界面虽然能够正常收发消息,但在细节上仍有明显不足:Markdown 格式未被正确渲染、实时消息与历史记录样式不一致、工具消息堆叠时占用过多空间、消息显示顺序错乱、以及滚动加载大量历史记录时体验不佳。 现在这个版本只是在交互上优化了一下,但是这个界面总觉得不够漂亮,不够大气,但是我又不知道怎么改才能看起来更舒服一些。。。 同时,在工程层面,项目正式更名为 XiaoMate/小美同学,并补充了 macOS 构建支持,现在可以同时发布 Windows 和 Mac OS 两个平台的版本。 经过这一轮重构和优化,现在 XiaoMate 的聊天窗口已经接近主流 LLM 聊天界面的体验标准: 当前版本:v2.1.8 下载地址 现在XiaoMate 已经可以支持不少的技能了,但是一直没时间来介绍一下,但是国庆已经过去了一半了,后面几天有空的话,我再整理一下,把XiaoMate目前已经支持的技能一个个的来介绍一下。 下面是完整更新说明。 一、聊天体验全面升级 这是本次更新的重头戏,涉及消息渲染、显示顺序、分页加载和交互细节等多个方面。 1. Markdown 渲染支持 问题背景: 修复方案: 渲染支持的内容: 语法 示例 效果 粗体 **文本** 文本 […]
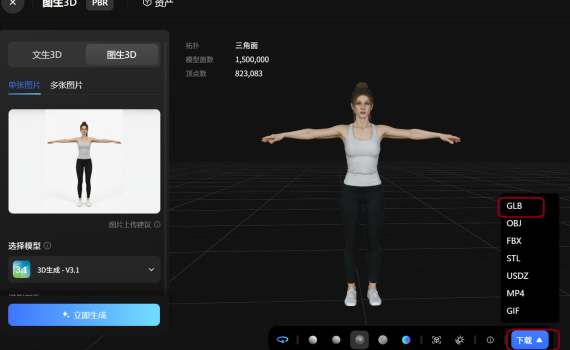
一、前言 想给我自己的桌宠【XiaoMate小美同学】搞一个写实的人物角色,所以趁这个中秋假期来试试看,昨天晚上开始问大模型如何可以用一张人物图片来生成一个3D人物模型,然后看解决方案,下载安装软件Blender(几百兆的文件,莫名其妙的下载了几个钟头),然后今天早上终于把基础流程走通了,但是还存在一些问题,最大的问题是原始生成的模型是有纹理的,但是搞到后面纹理丢失了,还不知道是哪一步的问题。 以下是整个流程,先跟大家分享一下: 二、关于XiaoMate XiaoMate是一个开源的智能桌面宠物应用,支持 2D和3D 模型,可以支持 AI 对话、待办提醒、自动任务、MCP技能调用等丰富功能。 1. 代码仓库 2. 快速开始 本次暂时只提供 Windows 绿色便携包,如果你只是想体验一下XiaoMate的效果,仅需要下载前端包就可以,后端可以先用公有云上的demo版本。 前端可前往 XiaoMate Desktop v2.0.7 发布页 下载;后端请前往 XiaoMate 后端仓库 获取。 两个都是绿色便携包,解压后,点击目录中的 start.bat 即可运行。 3. 注意事项 三、完整流程 步骤一、生成人物照片 既然是用混元3D来生成模型,那我就想是不是用同样是腾讯的模型来生成张图片,于是我就直接打开腾讯混元,然后跟它说:生成一张美女的照片,要求背景空白,姿势是T-pose,适用于在混元3d上生成人物模型 结果混元说:我这边不能直接生成并发送图片 于是我又打开千问,把混元输出的提示词喂给了千问。 完整提示词: 正面全身标准 T-pose 参考图,一位年轻成年女性,虚拟人物,面容清秀,表情中性,眼睛睁开,长发扎成低马尾或丸子头,露出额头、脖子和肩膀;身穿浅灰色紧身运动背心和黑色紧身瑜伽裤,衣服合身但不暴露,脚穿白色运动鞋或赤脚;双臂向两侧水平伸直,与肩同高,手掌朝下,手指自然伸直并微微分开,不握拳;双腿伸直,双脚与肩同宽,脚尖朝前;身体笔直站立,正对镜头;纯白色背景,无任何道具、家具、文字、水印;影棚均匀柔光,轻微接触阴影,超写实,高细节,8k,全身完整入镜,四周留白,不裁剪手臂和脚;适合 3D 建模的正面 T-pose 参考图,非性感,非暴露。 千问给我生成了一个美女,如下图所示。 步骤二、生成人物模型 登录混元3D官网:https://3d.hunyuan.tencent.com/我是混元3D的新注册用户,系统给我送了20次生成次数,也不知道是每天可以20次,还是总共只能白嫖20次。在那里选择“图生3D”,然后将千问生成的美女上传上去,再点下面的“立即生成” 过两分钟后,混元3D就把模型给你生成出来的,只不过脸部的一些细节有失真、僵硬的现象,咱先不管,咱现在要求没那么高。 然后我们选择将生成好的模型下载下来,我选择下载的模型类型是GLB格式的,因为我刚刚下载安装的Blender很干净,原始版本,啥插件也没有,纯粹是图方便、不想走弯路,事实上其他的一些格式也应该是OK的。 步骤三:用Blender清洗混元3D生成的模型 将下载下来的混元3D生成的glb模型import(导入)到 […]
更新周期:2026 年 9 月 26 日 当前版本:v2.0.7 前言 这段时间,XiaoMate 的更新重点只有一个:把桌宠的 3D 能力真正补齐,并让模型切换和动画播放变得稳定。 此前,XiaoMate 已经具备 Live2D 和 VRM 的基础加载能力,但在实际使用中仍然存在一些明显问题:Live2D 与 3D 模型来回切换时容易出现画面残留,播放 VRMA 或 FBX 动画后偶尔会停在 T-pose,模型尺寸和目录配置也缺少统一处理。 经过这几轮重构和修复,现在 XiaoMate 可以在同一个应用中加载并切换: 除了模型能力本身,本次还加入了透明区域点击穿透,将设置界面拆分为独立窗口,并修复了动画缓存、随机播放、默认模型路径和内存增长等问题。 下面是一次完整更新说明。 号外:项目正式更名为 XiaoMate 有朋友提到,Charlotty 这个名字相对偏向女性角色,而 XiaoMate 不限定角色性别:它既可以承载女性角色,也可以承载男性角色或宠物角色,因此项目名称调整为更加中性的 XiaoMate。 改名后的仓库地址如下: “小美同学”仍然保留为桌宠和快捷方式的名称。 快速开始 本次暂时只提供 Windows 绿色便携包: 前端可前往 XiaoMate Desktop v2.0.7 发布页 下载;后端请前往 […]
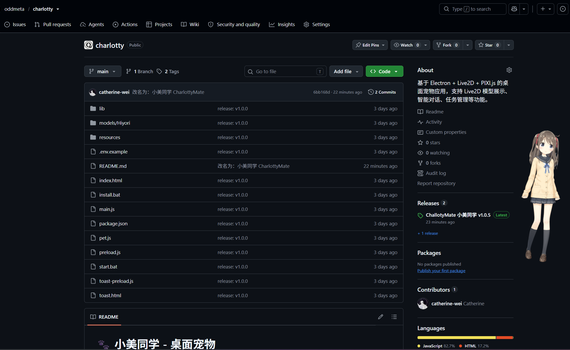
🐾 小美同学 – 桌面宠物 Catherine 同学提出要做一个桌宠,然后现在 TA 终于来了。这个桌宠的完整功能运行需要一个后端(https://github.com/catherine-wei/learning-ai ),目前使用的是部署在 99 元/年 阿里云服务器上的,但是这个阿里云服务器配置(2H+2G+2M)太差,跑一些基于playwright 的功能经常会失败(比如:小奥收藏,自动填报工时等),因此后面会再把后端再打一个包,让所有的服务都本地化运行,所有的数据不出你的电脑。 今天只是开一个头,后面再来更详尽的补充介绍一个这个项目。 基于 Electron + Live2D + PIXI.js 的智能桌面宠物应用,支持 Live2D 模型展示、AI 对话、任务管理、技能调用等丰富功能。 项目信息 ✨ 核心功能 🎭 Live2D 模型展示 🖱️ 窗口交互 💬 AI 智能对话 🎯 圆盘菜单 单击桌宠展开的环形菜单,包含以下功能: 🎵 音效系统 📋 任务管理 提醒待办 定时任务 🔧 MCP 技能系统 ⚙️ 设置系统 网络设置 […]
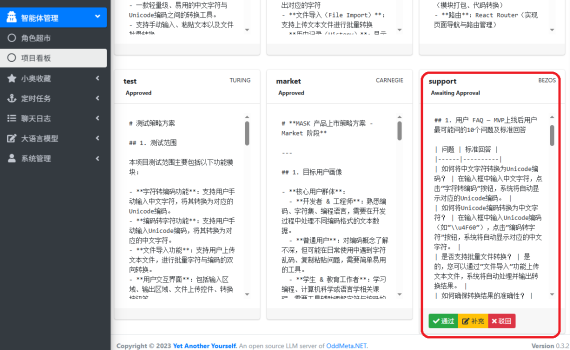
## 一、前言 前两天在哪个新闻上看到有人做了一个OPC,然后招了一些名人来帮他打工,挺美的,那篇文章一下子找不到了。 这个周末在家,我也给我的[小落同学](https://www.oddmeta.net/project-xl “小落同学”)招了几个员工,分别是 Musk, Jobs, Linus, Turing, Carnegie, Zezos,分别负责和担任小落同学的CEO,UCX,Developer, Test, Marketing, Support。 今天找了半天,想找之前看到的文章,并借鉴一下他的具体方案,但死活就是没找到,于是就先自己硬着头毛先实现一个版本试试。 这个月没有买token plan,然后前两天白嫖的小米MiMo大模型的token也过期了,所以我又回到了open code。 实现后,我让这些员工一起协同给小落同学设计了一个 `中文字符unicode转换的工具`,并跑通了整个流程。下面是整个流程全记录。 ## 二、思路及Spec探索 一些客套、扯蛋、吹牛的废话就省略了,直接上整个流程。 ### 1、思路探索 在opencode里打开小落同学的代码目录,输入提示词 #### INPUT:提出我的计划 “`bash 我在小落同学数据库中新增了几个角色,Musk, Jobs, Linus, Turing, Carnegie, Bezos等,希望让他们成为生产力工具,我跟Musk交待任务(MVP产品开发任务),然后Musk让Jobs设计,Linus开发, Turing测试, Carnegie市场销售推广,Bezos技术支持。 在现有的代码基础上设计一套agent框架流程,来实现这些角色的串联。 “` #### OUTPUT: 协作方式 “`bash 从项目探索来看,当前架构是单角色单轮对话模式,还没有任何多Agent编排能力。 我的第一个问题是理解交互流程: 你希望的协作方式是哪种? A. 全自动编排 — 你给Musk下达任务后,Musk自动拆解、依次分派给Jobs→Linus→Turing→Carnegie→Bezos,每个Agent的输出自动传递给下一个,最终返回完整结果给你 […]
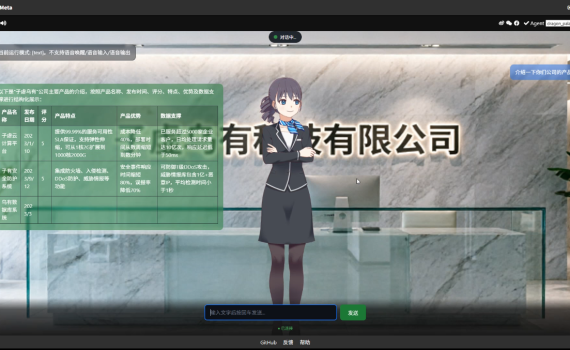
一、前言 半个多月前,计划着给我的小落同学做个改版,当时的目标是在一张消费级3060的GPU上跑全套虚拟人ASR+TTS+3DAvatar。 当时是计划着搞一台电脑,再去买一张3060的GPU,然后在上面跑全套的KWS+ASR+TTS+3DAvatar,但是后来想想现在去买3060实在有点过时,而如果要买新的50系列的卡呢又实在太贵,犹豫了几天后啥也没买,然后五一假期就到了。 于是,没办法,我只能继续在我这台10年前的老笔记本上折腾。于是,整个五一我就门也没出,一个人在家折腾这个东西了。于是,经过几天的折腾,现在终于有一个基础版本了。 市面上各种虚拟人方案多如牛毛,但是基本上清一色都需要GPU,咱买不起带GPU的电脑,所以自己手搓了这么一个方案。 简单汇总一下小落同学的优点如下: 百度网盘下载地址:https://pan.baidu.com/s/1y7ifkopK5ZesSgPUqxTY5A?pwd=vifz 提取码: vifz 二、先看效果 不废话,先直接看效果。简单录了两个视频, 一个是纯文本交互模式的, 另一个是全语音交互模式。 1. 在99元/年的2H2G阿里云ECS上跑产品知识问答(文本交互) https://www.bilibili.com/video/BV1htRvBWEfM 2. 十年前老笔记本(无GPU)上可跑全套语音交互,稍卡 https://www.bilibili.com/video/BV1xfReBVEQr 三、下载安装 1. 从github代码仓库下载 仓库地址:https://github.com/oddmeta/yay 克隆代码 安装依赖 运行服务 2. Windows绿色免安装包 无需安装python环境,无法安装依赖包/下载安装模型等繁杂的操作,解压缩后即可直接运行,使用的是硅基流动的免费API。私信:MetaYAY,即可获取。 四、进阶玩法 1. 完全本地运行(可断网运行) 若要完全本地运行,需自行下载ollama,并下载模型,然后修改根目录下的环境变量配置文件.env,将模型切换为本地的ollama,然后关闭运行中的metayay,再双击start.bat重新运行。 自行搜索教程。 根据你自己的硬件配置,下载不同尺寸的模型,具体什么模型适合你的硬件,可以把自己的硬件输入进去,问一下千问、豆包、Deepseek。 打开.env文件,将下面的三个变量设置成下面这样: LLM模型: Embedding模型: 注:若有多个设置,最终实际生效的是最下面的一个。 若已有启动YAY,先关闭,然后再双击 start.bat 重新启动。 浏览器打开:http://localhost:8000 ,测试验证。 2. 更新你自己的知识库 1)偷懒的办法 直接修改现有角色的知识库。 (1) 修改角色信息 […]
前言 我从去年开始就一直在零零碎碎的自己搞一个小落同学的项目,我的目标是: 给自己做一个专属的虚拟人,把 TA 当作我自己的树洞。每天或者隔一段时间,把想说的话、想吐槽的事都告诉 TA。等哪天想咨询点什么事的时候,去问 TA,看看 TA 记住的东西多了之后,会不会比我自己还了解我。 然后今天看到一个Pika的项目,于是就去研究、学习了一下。 一、它是什么? 当大多数 AI 厂商还在忙着卷工具的时候,Pika 突然发了条推:算了,不卷了,我们来”造人”。 2026 年 2 月,Pika 出了个叫 AI Selves 的产品。官方说法是:一个由你”孕育,培养并放手”的 AI 分身,成为你的一个活生生的延伸。 说人话就是:不是那种只会答题的聊天机器人,而是一个有记忆、会学你说话风格、能同时在好几个平台帮你跑业务的数字分身。 消息一出,科技媒体全在转。腾讯、网易、搜狐的标题都差不多——”不卷视频卷造人”。国外更热闹,评价两极分化,有人说是 AI 的下一个未来,也有人直接管这叫”AI 奴隶制”。 我看到的时候愣了一秒:这不就是我正在搞的”小落同学”吗? 今天来扒一扒这东西,顺便对比一下我的项目。 二、怎么用? 第一步:加入候补 现在还没全量开放,得先去官网排队: 官网入口:https://pika.me 支持 Google 账号和邮箱登录。邮箱注册可能要收个验证码,也可能直接进候补名单等通知。 第二步:设置你的分身 点 “Birth Your AI Self” 开始创建。 这一步决定你的分身有多像你: 官方原话:”一切由你决定。” 第三步:定外观 三个选项: […]
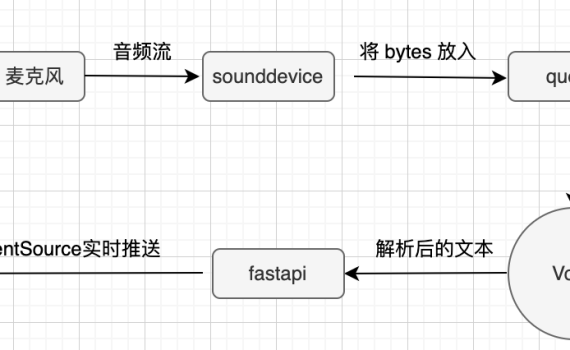
前面在我的笔记本上用FunASR和PaddleSpeech为小落同学整合了一下ASR的功能,但是发现在我的阿里云ECS上跑不动,由于是乎就想找一个最轻量级的ASR模型,让小落同学也可以用上免费白嫖的ASR功能。我的要求很简单: 翻烂Google, Baidu, Bing,搜遍github之后,当前收到的评估是:Vosk 是最紧凑、最轻量级的语音转文本引擎之一,可以支持20多种语言或方言,包括:英语、中文、葡萄牙语、波兰语、德语等,还可以支持Windows, Linux, Android、iOS和Raspberry Pi,而且Vosk 提供了小型语言模型,不占用太多空间,理想情况下,大约只有50MB。然而,一些大型模型可以占用高达1.4GB。该工具响应速度快,可以连续将语音转换为文本,还提供流媒体API(与流行的语音识别python包不同),还支持说话人识别(这个我暂时还没试过)。 既然如此,我只能说:兄弟,就是你了。以下是关于Vosdk从技术原理到实战代码。 一、Vosk相关介绍 在众多 ASR 工具中,Vosk 凭借以下核心优势脱颖而出: 二、Vosk 项目核心信息 三、快速安装指南(以 Python 为例) 1. 环境准备 要求使用Python 3以上版本环境,除非你的环境是古董级别的,不然都是Python 3以上,但是为防万一,还是建议你升级一下。虚拟环境就直接用小落同学的虚拟环境,不另外创建虚拟环境,也算是为我的ECS省点空间。 2. 安装 Vosk 库 3. 下载语音模型 支持的模型列表:https://alphacephei.com/vosk/models其中中文的我看有三个 模型名 大小 Word error rate/Speed 说明 License vosk-model-small-cn-0.22 42M 23.54 (SpeechIO-02) 38.29 (SpeechIO-06) 17.15 (THCHS) Lightweight model for […]
一、缘起 一直以来,我都有一个梦想,希望能拥有一个数字版的自己。 在此这前,我需要好好认真的去思考一下的是,要实现一个数字版的我自己,应该、可能、也许、大概、似乎可以怎么做? 这个问题我自己一个人想了很久,但是一直没有想清楚。暂时先用记录一下。 等有时间了,我再来一点点完善。也希望抛砖引玉,有志同道合的人可以一起来探讨。 目前为止,只是花了171块钱(阿里云ECS 99块钱每年,域名72块钱每年),做了一个初始版本的对话机器人:小落同学。 二、子系统分拆 1。后台 1。我告诉大模型关于我自己的一些初始信息:角色设定。2。我每天或者不定期的把发生在自己身上的故事告诉大模型。3。大模型帮我一件件记录下来,并能够自动识别和提取故事中的关键信息,比如日期、地点、人物、事件结果等,并将这些故事进行结构化存储。4。大模型定期(每个月?每个季度)或者不定期的形成阶段性的人格快照,将发生在这段时间内的各种有条理建立时间线、人物关系、关键事件等。5。随着关于我的信息的不断完善,大模型一点点复刻出来的我的身份。 2。前台 1。在小落同学的前端界面展示这个数字版的我,并允许他人来跟这个数字版的我进行对话,让这个数字版的我来代表我自己(提示对方,所有回复的内容仅供参考)。 三、初步设想 1。后台-角色设定的prompt(一次性任务) 系统人设prompt:你是我的数字记忆体和数字分身,将永久存储我的人生故事 2。后台-初始档案子系统(一次性任务) 3。后台-记忆库构建子系统(日常任务) 记录我每天分享的故事、观点、情感、聊天记录、邮件、社交动态。由我自己每天登录到后台,并将今天的事情跟小落同学汇报一下,然后由小落同学将这些事情一件件的总结输出,并保存的记忆中。 4。后台-人格模拟子系统(周期任务) 这个子系统用于: 待思考确认,是否先去研预一下Agentic RAG和Manus,是否可以让Agent来自动完成? 5. 前台-对话人设prompt 还没想清楚应该怎么来设置这个系统人设,但是应该包括下面这些内容。 示例: 6. 后台-针对与用户对话时的实现流程 当被问到一个关于“我”的问题的时候,除了要将与这个对话流相关的内容放到对话的history里进去外,还需要1)将用户的问题先做一下分词(单纯的jieba分词可能不好用),提取关键词。2)到记忆里去查找相对应的内容。如:最近的6条、与该用户相关的(绝大多数情况是陌生人)、隐私级别匹配的内容。3)查找到相对应的内容后,提取并组装内容,需要有日期、地点、人物、事件结果等。4)最后将这些记忆里的内容,加到与用户对话的对话流里的内容,整理成一个请求发送给大模型,并获取响应。 四、问题 1。技术实现问题 我可能希望这个模拟出来的“我”能够去跟任意人对话,对话的时候在应对和理解对方的话语的时候,这个prompt该如何动态的去设计?既有我“初始档案子系统”中的特征(核心价值观/口头禅/表情符号/语气特点等),又有我最近的心情/情绪/口头禅等。还需要加上我最近的访问最新的记录,并在生成回答时综合考虑用户的整个历史数据。 2。非技术问题 1。后台喂数据阶段,每个告诉大模型的事情的隐私级别的定义?(让大模型自行判断隐私级别?还是每次自己来指定?自己指定太麻烦,让大模型判断不放心)2。前台与用户交互时,如何区分哪些事情可以对谁公开?(隐私级别如何来判定?)3。存储的数据的隐私问题(要不要脱敏,如果要的话,如何个脱敏法?)4。数据的安全问题(加密?)5。要不要遗忘?如何实现遗忘机制?自动过期?自动摘要?手动删除记忆?如何判定脏记忆?(如果需要人干预的话,那就累了)6。其它。。。。