版本更新介绍 前阵子公司一位大佬跟我推荐了一下 Qwen3-ASR,平时在公司忙成狗也没时间来测试,周末回家给整合了一下到 OddASR,并简单的测试了一下。 时间关系,没有做广泛的测试,但在有限的测试集下发现: 同时也简单的对Qwen3-ASR 的几个版本分别做了些测试,并且也尝试了用一些不同的参数组合,包括:dtype精度、Batch size等。 顺便也对 BaseASR 基类做了一下重构,以让整个代码看上去逻辑更简单、清晰,让代码的可阅读性更好一些,顺便让各个不同模型的ASR子类代码做了一下精简,让各个子类的功能可以更加原子一些(业务和逻辑相关的代码都独立出来了)。 除此之外就是一些零零碎碎的修改,大致如下: 快速开始使用 OddASR Python测试: curl测试: Qwen3-ASR-1.7B和Qwen3-ASR-0.6B两个模型都需要GPU才能跑得动,如果没有GPU的话,建议不要启用这两个模型。 以下是完整的更新列表说明。 一、重磅:新增 Qwen3-ASR 系列模型 本次更新的核心亮点是引入了 Qwen3-ASR 系列模型,提供三种规格: 模型 参数量 适用场景 Qwen3-ASR-0.6B 0.6B 轻量部署,显存有限 Qwen3-ASR-1.7B 1.7B 平衡性能与资源 Qwen3-ASR-Flash 1.7B 1.7B 流式低延迟场景 显存优化亮点: 二、架构重构:更清晰、更可维护 1. ASR 模型注册表(asr_registry.py) 全新设计的模型注册机制,统一管理所有 ASR 后端的注册、实例化和生命周期。 2. BaseASR 参数封装 将 BaseASR […]
OddAsr
8 posts
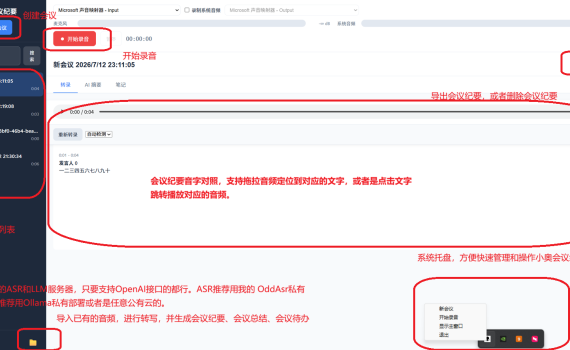
关于小奥录音 OddMinutes 小奥录音是一个开源的智能音频会议系统,支持实时录音、AI 转录、智能摘要生成和音字联动功能,也支持导入已有的音频进行转录、总结。跟 Meetily 一样,支持全链路私有化部署,完全离线运行。 Slogan:让会议的每一分钟,都被听见、被记录、被理解 —— OddMinutes 小奥录音 项目地址:https://github.com/oddmeta/oddminutes 安装:pip install oddminutes 运行:oddminutes Web前端: http://localhost:9011 最近两个周末,一边改 OddASR,一边陆陆续续的用 OddASR 再来一点点完善小奥录音的各项功能,今天向pypi发布了个阶段性的版本 v0.1.10 。然后这里汇总一下与上个版本相比做的一些修改、调整与完善,简单讲的话主要就是:围绕实时字幕、导出功能、说话人识别、AI纪要等核心体验进行了一些升级。具体看下面。 一、新功能 1. 实时字幕上线(500ms 超低延迟) 结合最新版 OddASR,小奥录音加入了实时字幕功能,首字时延低至 500ms! ●字幕风格参照主流音乐播放器,支持拖动调整字幕显示位置 ●默认不启用,可在系统设置中手动开启 ●录音控制面板新增「显示字幕」按钮,一键控制字幕显隐 2. 导出功能全新重构 导出功能经过彻底重设计: ●点击导出按钮后弹出选择框,可自由勾选导出内容:音频文件、会议文本、AI摘要 ●导出前自动检查数据库中是否已有对应的 PDF 文件,智能判断是否需要重新生成 ●勾选的导出文件自动打包成 ZIP 提供下载,文件名用会议名称(中文文件名兼容) ●导出的 PDF 新增页眉 小奥录音 Logo + Slogan、页脚副标题与官网地址 […]
当前最新版本:v2.5.5,已经上传到pypi,有需要的同学可以下载安装来体验一下。 安装:pip install oddasr运行:oddasrDemo: http://localhost:9002 默认启动只支持2路实时转写,再加1路离线转写。可通过自行修改配置文件中的最大实例数来放大。 自定义配置启动 项目地址:https://github.com/oddmeta/oddasr文档地址:https://oddmeta.net/docs/oddasr/ 一、本次更新的亮点 本周的核心工作集中在说话人分离(Speaker Diarization)的配置化与请求级可控上,同时围绕实时转写首字时延 / 返回速度、低配硬件可运行性、Web 前端体验做了多处优化,并修复了 WebSocket 在 HTTPS 环境下的兼容性问题。 这个版本里主要是这几个功能: 二、新功能(Feat) 下面是更新的具体的新功能。 1. 说话人分离 4 个核心参数落地 新增 preset_spk_num / max_num_spks / merge_thr / spk_mode 四参数,打通了 配置文件 → 离线转写 API → Web 前端 的完整链路。 参数 默认值 作用 对应 FunASR 内部机制 preset_spk_num 0 […]

其实版本陆陆续续有递交到pypi,只是今天做一个阶段性的总结。当前版本号为v2.5.1,近期的一些修改主要对 OpenAI API 的兼容性做了一些增强,同时更新覆盖实时性、准确率、功能广度、工程稳定性四个维度。 最新版本 v2.5.1,已经上传到pypi,有需要的同学可以下载安装来体验一下。 安装:pip install oddasr运行:oddasr 一、实时转写:首字时延从 1.5~2s 砍到 ~0.5s 在 v2.5.1 更新中最值得关注的性能优化 同时新增配置项 streaming_buffer_chunk_size(默认 4800,即 300ms 缓冲),方便手动调优服务端缓冲策略。 为了方便查看和统计时延,本次还为转写流程中每一个重点功能都加上了时延统计,便于线上观测与回归对比。 二、新功能上线 1. 热词(Hotwords)支持 Paraformer / SenseVoice 后端现已支持热词功能,可在转写时注入业务专有词,显著提升专有名词、人名、术语的识别准确率。 服务端做了优化:只在热词实际发生变化时才记录日志(比较新旧值),避免高频音频传输路径上日志刷屏。 2. diarized_json 返回格式 在 OpenAI 兼容的 response_format 基础上,新增 diarized_json,返回带说话人角色的结构化结果,方便直接消费”谁在什么时候说了什么”。老接口里说话人角色分离的接口依然可用:response_format:spk。 3. 字词级时间戳(word-level timestamps) verbose_json 模式下支持 OpenAI 兼容的 word-level 时间戳请求参数,可控制返回文本是否带每个字的时间戳,并修复了音字对照时间戳错位、英文单词间空格导致解析异常等问题。 4. 多种音频格式 […]
版本信息 更新说明 现有机制下,所有启用的模型都会在 OddASR 启动的时候检测模型是否已下载,若未下载会自动开始下载,而部分模型(如:SenseVoice ONNX)在国内下载不稳定,普通的环境经常下载失败,导致普通的、不会github上网的非技术人员在使用 OddASR 的时候体验不佳。 上周用 OddASR 做了一个录音转写的产品:小奥录音,考虑到产品的用户群主要是普通用户,因此,决定默认禁用一些下载不稳定的模型。 但是 OddASR 的所有模型的功能都还是完整的,知道如何稳定下载各模型的技术人员可以自行修改配置文件,将相应的模型启用起来即可。 详细功能修改 版本特性 2-Pass ASR 架构 OddASR 2.x 采用 2-Pass ASR 策略,结合流式识别和离线识别: 核心特性 快速开始 安装 服务启动后: 无需 config.json 配置文件,服务使用内置 DEFAULT_CONFIG 启动。如需自定义,创建 config.json 覆盖需要修改的项即可。切换模型时若配置文件不存在会自动创建。 Python 客户端 OddAsr支持OpenAI兼容接口,推荐使用OpenAI的API接口来调用。 版本历史 v2.x (当前) 系统要求 常见问题 首次运行需要下载模型吗? 是的,首次运行需要下载 ASR 模型。可以通过设置 HuggingFace 镜像加速: […]
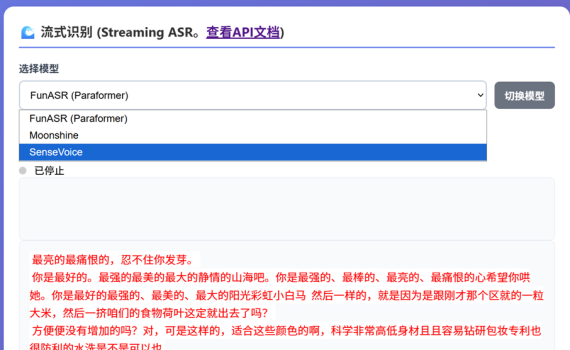
引言 前阵子发现,我五一假期几天搞的小落同学新版本的文章《可用十年前老笔记本纯CPU跑的全套虚拟人方案》被微信判定为违规,一下子打消了我写公众号的积极性,所以这段时间都不太想写公众号。 OddASR 是一个兼容 OpenAI API 的自动语音识别(ASR)服务器,支持离线转录和流式转录。让语音转写更简单。 距离上次发版又过去了几个月,OddASR 陆陆续续发布了一些重要更新。无论是端侧纯 CPU 运行的突破、多音频格式的全面支持,还是前端自由切换模型的灵活体验,每一次更新都为了让语音转写变得更简单、更强大。 昨天,大佬大白菜 反馈了一些问题,我当时在上班没有时间处理,结果他自己直接帮我修复了。 今天我在家也顺便把他帮忙改的代码也合到了主分支,然后顺便也发布了一个新的版本 2.4.6,这里就盘点一下 OddASR 近期的一些更新,顺手把文档也更新了一下(今年一直在忙公司那边的一个智能运维的项目,每天跟产品、测试、需求纠缠不清,包括OddASR、小落同学等项目也都一直没时间搞,更别说是一些文档了)。 一、SenseVoice ONNX 版:端侧 CPU 也能飞 最大的更新莫过于SenseVoice ONNX 版本 的加入,这主要是应对小落同学要在我那个十年前的老笔记本上跑的需求。 借助 sherpa-onnx 框架,SenseVoice 现在可以在纯 CPU 环境下流畅运行,无需 GPU 也能获得出色的识别效果。这对于没有独立显卡的服务器、笔记本乃至边缘设备来说,无疑是个巨大的福音。 功能对应「小落同学」的新版本,特别感谢 大蟑螂 和 大白菜 两位大佬的贡献支持和建议!” SenseVoice 同时支持离线转写和模拟流式输出(基于内置 VAD),成为继 Paraformer、Moonshine 之后的第三大后端引擎。 个人推荐:FunASR > SenseVoice > Moonshine […]
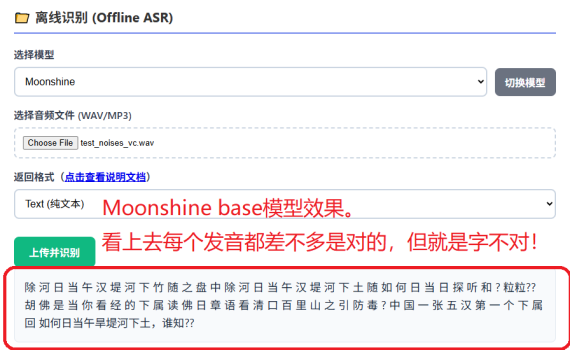
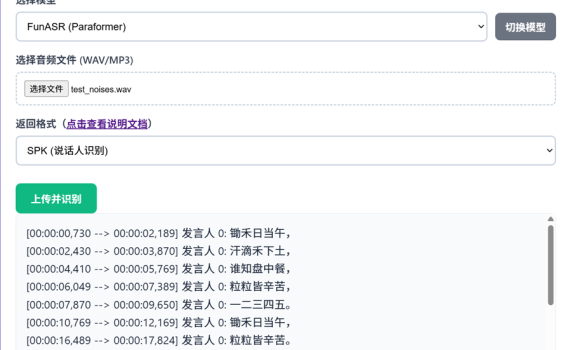
前两天研究了一下Moonshine Voice,当时拿了几个简单的音频文件测试了一下,感觉效果还可以,所以我就开始将其整合到了OddASR项目里。 但是在完成了整合后,再进行测试的时候发现一些比较严重的问题,所以,我又赶紧把我刚刚上传到pypi的OddASR给撤了,然后重新将主力模型改回到paraformer-zh-streaming和paraformer-zh。 当前OddAsr最新版本:v2.1.0,已恢复paraformer模型。 以下是在OddAsr自带的测试界面上分别跑paraformer-zh和moonshine base模型的效果 测试音频 具体的声音情况可以看这个视频: https://mp.weixin.qq.com/s/y4l-YtaUhayV9k9EDatCzw 注:这个视频中并未使用我的OddASR,效果差不是我OddAsr项目的锅。相反,下面我后来有将这个视频中的音频提取出来,专门作为OddAsr的一个测试集,每次测试不同的ASR模型的时候都会来测试一下这种场景。比如:这次的Moonshine base中文模型的测试。 测试效果 测试使用的音频就是上面那个视频里提取出来的音频。 paraformer模型效果 只想用一个字来形容:bravo! moonshine base模型效果 看上去转写出来的每个发音都是对的,但是。。。。这些个字呢。。。。好像就没几个是对的。 总结 唉,如果不是因为我这个用了超过十年的老笔记本CPU不太够用,我也完全不想去折腾一些其他的轻量级的ASR模型。
由于我在做的小落同学(https://x.oddmeta.net)项目需要用到ASR功能,之前针对 FunASR、FireRedAsr、Vosk等ASR项目也做了一些评测,但是总体跑下来发现还是FunASR的整体表现最好,所以我就将FunASR给封装了一下,做了一个OddAsr的项目。 而考虑到ASR功能的用途广泛,之前也有一些朋友私下问过我相关的一些使用和封装的问题,尤其是流式ASR的支持(github上有好多FunASR的API封装,但是全是离线文件转写的,没有一个同时支持离线文件转写和流式转写的API封装项目),想了一下干脆直接把它开源出来吧。希望对有ASR需求的同学有帮助。 项目地址: https://github.com/oddmeta/oddasr 之前关于ASR相关的一些测试 ASR引擎测试:FireRedASR只能说小红书的诚意不够,https://www.oddmeta.net/archives/144ASR引擎测试:FunASR,必须给阿里点一个赞,https://www.oddmeta.net/archives/165可能是最紧凑、最轻量级的ASR模型:Vosk实战解析,https://www.oddmeta.net/archives/201 项目简介 OddASR是一个简单的ASR API服务器,基于强大的开源语音识别库FunASR构建。FunASR由ModelScope开发,提供了丰富的预训练模型和工具,可用于各种语音识别任务。OddASR的目标是简化FunASR的部署,满足非实时音频处理的需求,同时也为实时流式转写提供了支持。 项目具有以下特点: 安装步骤 1. 克隆仓库 2. 安装依赖 使用方法 1. 启动REST API服务器 服务器将在http://127.0.0.1:12340上启动。 2. 测试文件ASR API 使用testAPI.py脚本测试API: 也可以使用curl命令发送音频文件到REST API: 3. 测试流ASR API 使用testStreamAPI.py脚本测试API: 4. 示例输出 5. Docker部署 项目待办事项 参考资料 如果你对语音识别技术感兴趣,不妨试试OddASR。它简单易用,功能强大,能为你的语音转文字工作带来极大的便利。快来体验吧!