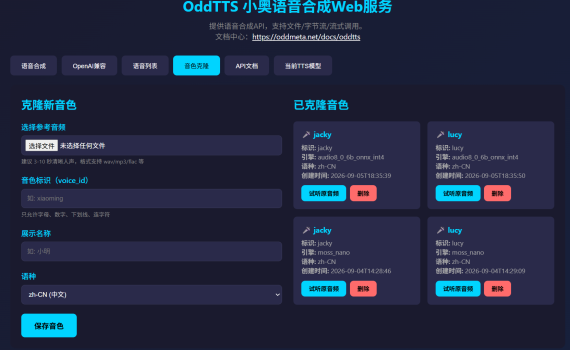
引言 上周把 Audio8/MOSS-TTS-Nano 集成到 OddTTS 了,测试一下 Audio8/MOSS-TTS-Nano 效果确实好,但 CPU 跑 RTF 3.26(55字合成耗时 27.85 秒),实在没法用于实时场景。 除了这两个模型个,kid 大佬推荐的模型里还差了一个 ZipVoice,123M 参数,Flow Matching 架构,号称”Small and Fast”。 这个周末在家就搞了一下这个模型。 然而,这个 zipvoice 的集成过程并不顺利,甚至可以说一波三折——踩了好多个大坑,从 PyTorch 推理跑不动,到 vocoder 选型错误合成出噪音,再到模型目录验证 bug 导致 voices 为空。这篇文章把这些坑都记录下来,希望能帮到同样想集成 ZipVoice 的同学。 最终方案:sherpa-onnx 推理后端 + ModelScope 模型下载 + 自动 vocoder 下载,pip 安装后一键启动,纯 CPU 运行,RTF 约 1.3-3.0。 […]
ONNX
1 post