引言
上周把 Audio8/MOSS-TTS-Nano 集成到 OddTTS 了,测试一下 Audio8/MOSS-TTS-Nano 效果确实好,但 CPU 跑 RTF 3.26(55字合成耗时 27.85 秒),实在没法用于实时场景。
除了这两个模型个,kid 大佬推荐的模型里还差了一个 ZipVoice,123M 参数,Flow Matching 架构,号称”Small and Fast”。
这个周末在家就搞了一下这个模型。
然而,这个 zipvoice 的集成过程并不顺利,甚至可以说一波三折——踩了好多个大坑,从 PyTorch 推理跑不动,到 vocoder 选型错误合成出噪音,再到模型目录验证 bug 导致 voices 为空。这篇文章把这些坑都记录下来,希望能帮到同样想集成 ZipVoice 的同学。
最终方案:sherpa-onnx 推理后端 + ModelScope 模型下载 + 自动 vocoder 下载,pip 安装后一键启动,纯 CPU 运行,RTF 约 1.3-3.0。
快速开始使用 OddTTS
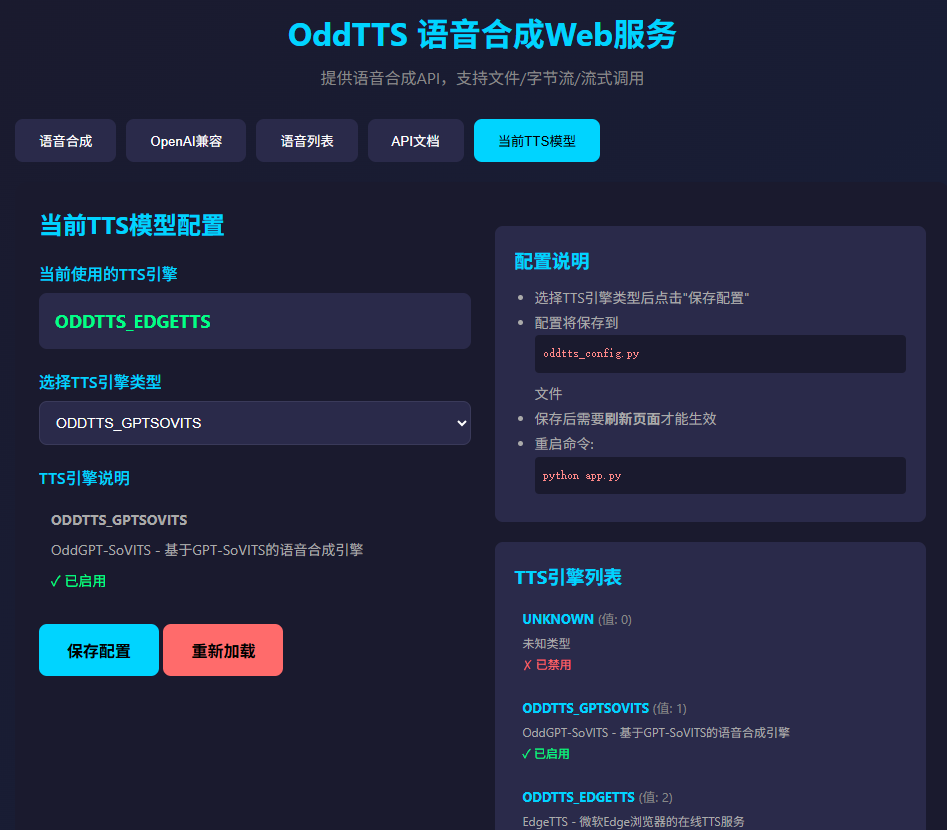
OddTTS 是一个功能强大的多引擎语音合成服务,提供统一的API接口和友好的Web界面,一套接口搞定多种主流TTS引擎,包括 EdgeTTS、Kokoro-82M-v1.1-zh、ZipVoice、MOSS-TTS、Audio8、ChatTTS、Bert-VITS2、GptSovits v2等,同时也支持OpenAI TTS API的调用。
- 仓库:
https://github.com/oddmeta/oddtts - Python版本:
3.12 - 版本:
v2.1.15 - 安装:
pip install oddtts - 运行:
oddtts - 演示:
http://localhost:9001
Python测试
import openai
client = openai.OpenAI(base_url="http://localhost:9001/v1", api_key="dummy")
response = client.audio.speech.create(
    model="oddtts-zipvoice",
    voice="news-female",
    input="你好,欢迎使用OddTTS小奥语音合成服务。"
)
curl测试
curl http://127.0.0.1:9001/v1/audio/speech -H "Content-Type: application/json" -d "{\"input\": \"你好,欢迎使用OddTTS小奥语音合成服务。\", \"voice\": \"news-female\"}" --output speech.wav直接听合成的效果
合成文本:关注我的公众号:奥德元,一起学习 AI,一起追赶时代。Good good study, day day up!
zipvoice-cctv-voice1.wav(news-female 音色,RTF=1.551)
zipvoice-cctv-voice2.wav(news-female-2 音色,RTF=1.410)
zipvoice-leijun-voice.wav(leijun-1 音色,RTF=1.307)
一、ZipVoice 模型概览
1.1 基本信息
| 特性 | 值 |
|---|---|
| 参数量 | ~123M |
| 架构 | Flow Matching (4步迭代) |
| 量化方式 | INT8 (sherpa-onnx 预编译) |
| 采样率 | 24000 Hz |
| 支持语言 | 中文 + 英文(中英混合) |
| 音色克隆 | 零样本,仅需 3 秒参考音频 |
| 推理后端 | sherpa-onnx (ONNX Runtime) |
| 模型大小 | ~186 MB (encoder + decoder + vocoder) |
| 内存占用 | ~500-800 MB |
1.2 架构
ZipVoice 采用 Flow Matching 架构,核心流程:
文本 → Tokenization (espeak-ng) → Encoder → Decoder (Flow Matching, 4步) → Vocoder (Vocos) → 音频
                                          ↑
                                    参考音频 (音色克隆)
相比传统扩散模型,Flow Matching 仅需 4 步迭代即可生成频谱,推理速度大幅提升。
1.3 模型文件
sherpa-onnx-zipvoice-distill-int8-zh-en-emilia/
├── encoder.int8.onnx     # 文本编码器 (INT8)
├── decoder.int8.onnx     # Flow Matching 解码器 (INT8)
├── tokens.txt            # Token 词汇表
├── lexicon.txt           # 发音词典
├── espeak-ng-data/       # espeak-ng 音素数据
├── test_wavs/            # 内置参考音频
│   ├── prompt.txt        # 音色列表
│   ├── news-female.wav
│   ├── news-female-2.wav
│   └── leijun-1.wav
└── vocos_24khz.onnx      # Vocos 声码器 (100-mel, 24kHz)
1.4 内置音色
| 音色名称 | 描述 |
|---|---|
news-female | 新闻联播女声,正式风格 |
news-female-2 | 新闻联播女声2,另一播音风格 |
leijun-1 | 雷军演讲风格 |
二、踩坑过程
这是本文的重点。集成 ZipVoice 的过程并不顺利,遇到了几个比较典型的问题。
2.1 坑1:PyTorch 官方仓库 CPU 跑不动
时间:2026-09-12
最初集成时,直接用 ZipVoice 官方 GitHub 仓库的推理代码。需要的依赖:
pip install torch torchaudio vocos pypinyin jieba safetensors huggingface_hub模型从 HuggingFace 自动下载,推理用官方 infer_zipvoice 脚本。跑是跑通了,但速度完全无法接受:
合成耗时: 74.70s, 音频时长: ~10s, RTF > 7
合成耗时: 89.04s, 音频时长: ~10s, RTF > 8
合成耗时: 98.31s, 音频时长: ~10s, RTF > 9
RTF > 7 意味着合成 1 秒音频需要 7 秒以上,完全不可用于实时场景。而且 PyTorch 依赖太重了,pip 安装后光 torch 就好几个 GB。
结论:PyTorch 推理方案在纯 CPU 场景下不可行。
2.2 坑2:sherpa-onnx 方案搞定了速度,但 vocoder 选型错误
时间:2026-09-13 上午
发现 k2-fsa 官方在 sherpa-onnx 中提供了 ZipVoice 的预编译 INT8 模型,仓库名 sherpa-onnx-zipvoice-distill-int8-zh-en-emilia。这意味着不需要 PyTorch,直接用 sherpa-onnx(底层是 ONNX Runtime)就能跑。
马上切换方案,用 sherpa-onnx 重写了 tts_zipvoice.py。模型从 ModelScope 下载(国内速度快),依赖只剩 sherpa-onnx 和 soundfile。
但合成出来的音频是噪音!
查了半天原因,最后发现是 vocoder 选型错误:
- 模型仓库里自带了一个
vocos-22khz-univ.onnx,80 个 mel 频段 - 但 ZipVoice decoder 输出的是 100 个 mel 频段
- 80 mel 的 vocoder 去解码 100 mel 的频谱,结果就是噪音
正确的 vocoder 是 vocos_24khz.onnx(100 mel 频段,24kHz),需要单独下载。
2.3 坑3:vocoder 下载源踩坑
找到正确的 vocoder 后,需要自动下载。 给了一个 ModelScope URL:https://www.modelscope.cn/models/roarson/vocos_24khz.onnx。
第一次用 roarson/vocos_24khz 作为 repo ID 下载,ModelScope 返回 404。
# 错误的 repo ID
snapshot_download("roarson/vocos_24khz", local_dir=target_dir)
# 结果: 404 Not Found
试了好几个变体都不行。后来仔细看 URL,发现文件名就是 repo ID 的一部分:
# 正确的 repo ID(带 .onnx 后缀)
snapshot_download("roarson/vocos_24khz.onnx", local_dir=target_dir)
# 成功!vocos_24khz.onnx (51.6 MB)教训:ModelScope 的 repo ID 不一定和文件名一致,需要看实际 URL。
2.4 坑4:_validate_model_dir 用错了 isfile vs isdir
时间:2026-09-13 下午
vocoder 问题解决后,pip 安装的用户反馈:voices 列表为空。
查日志发现 get_voices() 返回 [],但没有报错。因为原来的代码是:
async def get_voices(self):
    if self._builtin_voices is None:
        try:
            self._init_runtime()
        except Exception:
            pass  # ← 吞掉了所有异常!
    return self._builtin_voices or []
_init_runtime() 失败了但异常被静默吞掉,导致 voices 为空却看不到任何错误信息。
加上日志后发现问题根源:_validate_model_dir() 中检查 espeak-ng-data 时用了 os.path.isfile():
# 错误:espeak-ng-data 是目录,不是文件
return os.path.isfile(os.path.join(path, ESPEAK_DIR))  # 永远返回 False
# 正确:
return os.path.isdir(os.path.join(path, ESPEAK_DIR))这导致模型目录验证永远失败,_get_model_dir() 返回 None,_init_runtime() 抛异常,get_voices() 静默返回空列表。
修复:os.path.isfile() → os.path.isdir(),同时在 get_voices() 中加上 logger.warning() 输出异常信息。
三、性能对比
3.1 测试环境
- 测试文本:55字中文文本(含中英混合)
- 测试条件:纯CPU,WAV格式
- 硬件环境:普通PC(无GPU)
3.2 性能数据
| 引擎 | 采样率 | 合成耗时 | 音频时长 | RTF(实时率) |
|---|---|---|---|---|
| Kokoro v1.1 | 24000 Hz | 2.68秒 | 8.18秒 | 0.33 |
| ZipVoice INT8 | 24000 Hz | 13.26秒 | 8.55秒 | 1.551 |
| Audio8 0.1B ONNX INT8 | 44100 Hz | 27.85秒 | 8.54秒 | 3.26 |
| Audio8 0.6B ONNX INT4 | 44100 Hz | 42.34秒 | 8.59秒 | 4.93 |
3.3 ZipVoice 各音色实测
| 音色 | 音频时长 | 合成耗时 | RTF |
|---|---|---|---|
| news-female | 8.55s | 13.26s | 1.551 |
| news-female-2 | 7.95s | 11.21s | 1.410 |
| leijun-1 | 5.91s | 7.72s | 1.307 |
3.4 性能分析
- Kokoro v1.1 仍是最快的,RTF=0.33,但不支持音色克隆
- ZipVoice INT8 RTF≈1.3-3.0,比 Audio8 快 2 倍以上,且支持零样本音色克隆
- Audio8 音质最好但最慢,适合对质量要求高的离线场景
ZipVoice 在速度和功能之间取得了不错的平衡:比 Kokoro 稍慢但支持音色克隆,比 Audio8 快得多且依赖更轻。
四、代码实现细节
4.1 引擎注册
在 oddtts_params.py 中新增枚举值:
class ODDTTS_TYPE(Enum):
    ODDTTS_ZIPVOICE = 11
在 base_tts_driver.py 中注册策略:
elif tts_type == ODDTTS_TYPE.ODDTTS_ZIPVOICE:
    tts.client = ZipVoiceAPI()
    return tts
4.2 sherpa-onnx 配置
import sherpa_onnx

config = sherpa_onnx.OfflineTtsConfig(
    model=sherpa_onnx.OfflineTtsModelConfig(
        zipvoice=sherpa_onnx.OfflineTtsZipvoiceModelConfig(
            tokens=os.path.join(model_dir, "tokens.txt"),
            encoder=os.path.join(model_dir, "encoder.int8.onnx"),
            decoder=os.path.join(model_dir, "decoder.int8.onnx"),
            data_dir=os.path.join(model_dir, "espeak-ng-data"),
            lexicon=os.path.join(model_dir, "lexicon.txt"),
            vocoder=vocoder_path,  # vocos_24khz.onnx
        ),
        num_threads=2,
    ),
)
tts = sherpa_onnx.OfflineTts(config)
4.3 模型自动下载
优先从 ModelScope 下载(国内友好),GitHub 作为 fallback:
ZIPVOICE_REPO_ID = "roarson/sherpa-onnx-zipvoice-distill-int8-zh-en-emilia"
# ModelScope → 自动下载到 models/zipvoice/

VOCODER_REPO_ID = "roarson/vocos_24khz.onnx"
# 单独下载 vocos_24khz.onnx 到模型目录
4.4 内置音色发现
从 test_wavs/prompt.txt 自动解析内置音色:
news-female.wav 各位村民, 大家新年好! 近期, 湖北省武汉市等多个地区
news-female-2.wav 本台消息, 中共中央国务院, 近日印发关于构建数据基础制度,
leijun-1.wav 那还是36年前, 1987年. 我呢考上了武汉大学的计算机系每行格式:文件名.wav 参考文本,自动解析为音色列表。
4.5 合成调用
audio = self.tts.generate(
    text=text,
    prompt_text=ref_text,
    prompt_samples=samples.tolist(),  # 参考音频采样点
    sample_rate=sr,
    speed=1.0,
    num_steps=8,  # Flow Matching 迭代步数
)
五、实际应用指南
5.1 安装与配置
# 安装OddTTS(sherpa-onnx 会自动安装)
pip install oddtts

# 启动服务(首次启动会自动下载模型 + vocoder)
oddtts
5.2 切换引擎
在 Web 界面中选择引擎:Zipvoice
或在配置文件中修改:
# oddtts_config.py
"tts_type": ODDTTS_TYPE.ODDTTS_ZIPVOICE
5.3 API调用示例
import requests

# 生成语音文件
response = requests.post("http://localhost:9001/v1/audio/speech", json={
    "input": "关注我的公众号:奥德元,一起学习 AI,一起追赶时代。",
    "voice": "news-female",
    "response_format": "wav",
    "model": "oddtts-zipvoice"
})

# 保存音频文件
with open("output.wav", "wb") as f:
    f.write(response.content)
5.4 OpenAI 兼容 API
from openai import OpenAI

client = OpenAI(base_url="http://localhost:9001/v1", api_key="dummy")

response = client.audio.speech.create(
    model="oddtts-zipvoice",
    voice="news-female",
    input="Hello, this is a ZipVoice TTS test with Chinese and English mixed text. Good good study, day day up!"
)
response.stream_to_file("output.wav")
六、总结与展望
6.1 本次更新的意义
- 新引擎:为 OddTTS 增加了 ZipVoice 引擎,填补了”中等速度 + 音色克隆”的空白
- 轻量部署:sherpa-onnx 方案无需 PyTorch,pip 安装后一键启动
- 国内友好:模型从 ModelScope 下载,无需翻墙
- 自动配置:vocoder 自动下载,模型目录自动检测,开箱即用
6.2 踩坑经验总结
| 问题 | 原因 | 解决方案 |
|---|---|---|
| PyTorch CPU 太慢 | 官方仓库用 PyTorch 推理 | 切换 sherpa-onnx |
| 合成噪音 | vocoder mel 频段不匹配(80 vs 100) | 使用正确的 vocos_24khz.onnx |
| vocoder 下载 404 | ModelScope repo ID 带 .onnx 后缀 | 用 roarson/vocos_24khz.onnx |
| voices 为空 | os.path.isfile() 检查目录 | 改为 os.path.isdir() |
| 异常被吞掉 | get_voices() 静默 catch | 加 logger.warning() |
6.3 后续优化方向
- 语音克隆:当前仅使用内置 preset voices,后续可开放零样本语音克隆功能
- 流式生成:实现真正的流式输出,减少首字延迟
- 性能优化:调整
num_steps参数(4步 vs 8步)权衡速度和质量 - 更多音色:支持用户上传自定义参考音频