引言 上周把 Audio8/MOSS-TTS-Nano 集成到 OddTTS 了,测试一下 Audio8/MOSS-TTS-Nano 效果确实好,但 CPU 跑 RTF 3.26(55字合成耗时 27.85 秒),实在没法用于实时场景。 除了这两个模型个,kid 大佬推荐的模型里还差了一个 ZipVoice,123M 参数,Flow Matching 架构,号称”Small and Fast”。 这个周末在家就搞了一下这个模型。 然而,这个 zipvoice 的集成过程并不顺利,甚至可以说一波三折——踩了好多个大坑,从 PyTorch 推理跑不动,到 vocoder 选型错误合成出噪音,再到模型目录验证 bug 导致 voices 为空。这篇文章把这些坑都记录下来,希望能帮到同样想集成 ZipVoice 的同学。 最终方案:sherpa-onnx 推理后端 + ModelScope 模型下载 + 自动 vocoder 下载,pip 安装后一键启动,纯 CPU 运行,RTF 约 1.3-3.0。 […]
TTS
5 posts
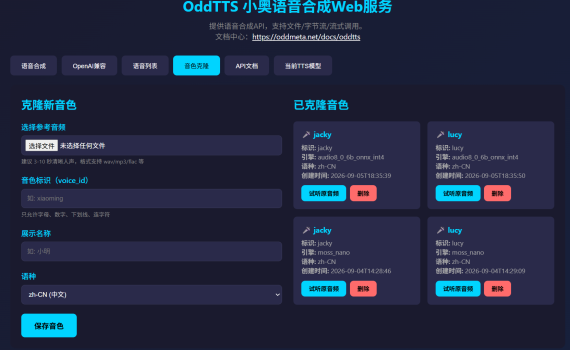
引言 这两个星期,在 大白菜 大佬和 Kid 大佬的提点下,完成了 Audio8 和 MOSS-TTS-Nano 两个轻量级 TTS 引擎的集成工作,也让一直定位于轻量级语音合成的 OddTTS 的引擎矩阵越来越丰富。与此同时刚才这两个引擎都支持音色克隆(zero-shot voice cloning),昨天晚上想起来这摊子事后,就决定把 OddTTS 的音色克隆功能给搞一下,并将这个能力给暴露出来。 今天搞了一天,还算是比较顺利的把音色克隆功能完整实现了,并作为 v2.0 的核心特性发布。 现在,你只需要上传一段 3-10 秒的参考音频,就能在 OddTTS 中注册一个自定义音色,像内置音色一样随时调用——无论是通过 Web 界面还是 OpenAI 兼容 API。 在这个周末,俺终于可以说 OddTTS 完成了从 v1.x 到 v2.0 的跨越。音色克隆功能首批支持 MOSS-TTS-Nano、Audio8 0.1B ONNX INT8、Audio8 0.6B ONNX INT4 三个引擎。后面如果有更多轻量级的 TTS 引擎和模型,我也会持续的将一些适合的引擎一个个的加进 OddTTSk 中,以支持更多引擎。 […]
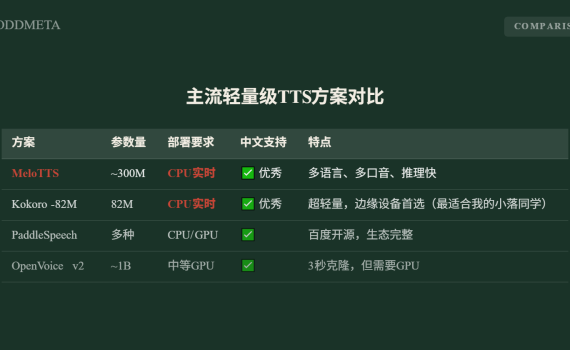
一、前言 你有没有想过,让电脑帮你念一段文章?或者给家里的智能设备添加语音播报功能? 很多人第一次接触语音合成(TTS),想到的是讯飞、百度这些云端API。但仔细一算:调用一次要花钱、网不好会卡顿、隐私数据还要传出去——这对于普通用户来说,门槛实在太高了。 更现实的需求是这样的: 这些场景共同的特点是:设备性能有限、没有显卡、最好能离线使用、还要省钱。 这就是轻量级TTS的用武之地。 二、轻量级TTS方案对比 说方案、对比方案前,先用我实测的一些音频大家听一下效果,感受一下MeloTTS的实际效果。 中英混合:欢迎关注我的公众号:奥德元。一起学习AI,一起追赶时代。Good good study, day day up. 英文-美国口音: text to read 英文-澳大利亚口音: text to read 2.1 主流轻量级TTS方案一览 方案 参数量 部署要求 中文支持 开源协议 特点 MeloTTS ~300M CPU实时 ✅ 优秀 MIT 多语言、多口音、推理快 espeak-ng – 超低资源 一般 GPL 体积超小(4MB),音质机械 Flite – 低资源 ❌ C 轻量但效果一般 VITS […]
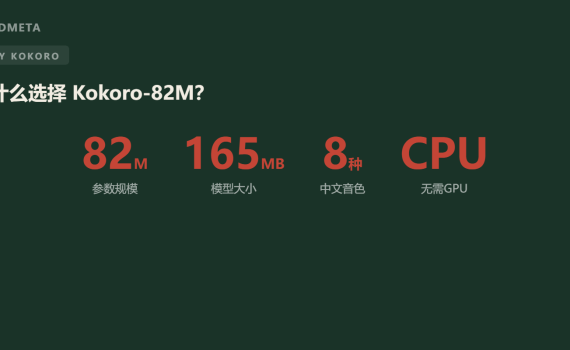
一、前言 你是否遇到过这样的场景:想给项目添加语音合成功能,却被各种问题困扰——要么模型太大动辄几GB,要么必须依赖GPU云端API,要么商用授权一团糟。 对于个人开发者和小型团队来说,一个理想的TTS方案应该满足三个条件:轻量到能在CPU上跑、免费可商用、效果足够自然。 今天要介绍的 Kokoro-82M,就是这样一款满足所有条件的神器。它只有82M参数,却能输出相当自然的中文语音;体积小巧到只需几百MB,却支持8种不同音色。更重要的是——它完全开源,Apache 2.0许可,零成本商用。 二、方案介绍 概念 定义 Kokoro-82M 由 hexgrad 开发的轻量级TTS模型,仅82M参数,支持8种中文音色 ONNX优化 模型经过ONNX优化,可在CPU上高效推理,无需GPU 语音管道(Pipeline) Kokoro 的核心API,负责分词、音素转换、语音合成全流程 音色(Voice) 预训练的音色模型,不同音色适合不同场景 为什么选择 Kokoro? 指标 数值 参数规模 82M 模型大小 ~165MB 输出采样率 24kHz 支持语言 中文、英语、日语、韩语等8种 中文音色数 8种(4女4男) 推理设备 CPU / GPU 许可协议 Apache 2.0 对比同级别模型,Kokoro 在中文场景下表现尤为突出——不仅音色自然,而且对中文多音字的处理也相当不错。对于没有GPU的个人开发者来说,这可能是目前最优的中文TTS本地方案。 先实际听一下用kokoro合成的音频 我用kokoro生成了一下奥德元的口号:关注我的公众号:奥德元,一起学习 A I,一起追赶时代。,一个男声,一个女声,大家可以实际听下、感受一下合成的语音的效果。 男声: zm_yunyang: kokoro_zm_yunyang.wav女声: […]
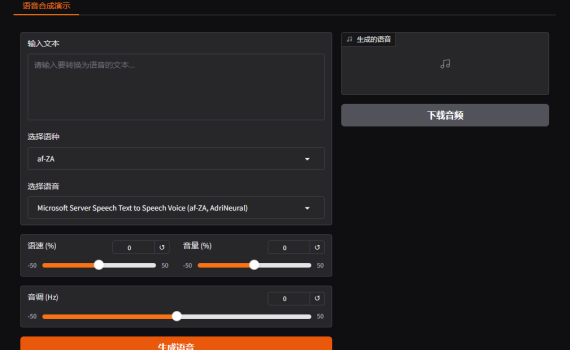
一、前言 前阵子有一位同学来问我,小落同学的TTS功能是怎么实现的?我跟他解释了半天,发现双方对一些基础技术、知识、名词都无法对齐,沟通起来实在有些累。后来实在没办法,就跟他说,我把小落同学的TTS功能的代码开源出来,然后你自己直接看代码吧,过了半个钟头,他回来跟我说:非常感谢,对着代码看,一目了然。 呵呵,果然程序员之间的沟通最简单、有效的方式还是:Talk is cheap, show me the code OddTTS的代码绝大部分都是Catherine同学在高考结束后暑假期间写的,而明天她即将开始大学生涯的第一节课,今天特补上这个文章纪念一下高中生涯的结束,并迎接大学学习的正式开始。 二、什么是OddTTS? OddTTS是一个简单的多引擎语音合成服务,整合了当前主流的TTS引擎(如EdgeTTS、GPT-Sovits、Bert-VITS2等),并提供统一的API接口和友好的Web界面。无论你是开发者需要集成语音合成功能,还是普通用户想快速生成语音,OddTTS都能胜任。 项目地址:https://github.com/oddmeta/oddtts 普通用户可以直接访问 http://localhost:9001 即可打开可视化界面开发者可通过http://localhost:9001/api/oddtts/ 接口进行开发集成 三、为什么选择OddTTS? 1. 多引擎支持,语音风格多样 OddTTS集成了多种主流TTS引擎,包括: 你可以根据需求自由切换引擎,轻松获得不同风格的语音输出。 注意:OddGptSovits这个引擎不是开箱即用的,需要用户自己部署GPT Sovits,然后再照着EdgeTTS的API封装一下才能接入到OddTTS 2. 灵活的调用方式 无论你需要哪种输出形式,OddTTS都能满足: 3. 开箱即用的Web界面 启动服务后,通过浏览器访问即可打开基于Gradio的可视化界面,支持: 4. 完善的API服务 开发者可以通过RESTful API轻松集成到自己的系统中,主要接口包括: 5. 高度可配置 通过简单修改配置文件,即可实现: 四、快速上手教程 环境要求 安装步骤 1. 克隆项目代码 2. 灵活的调用方式 无论你需要哪种输出形式,OddTTS 都能满足: 3. 开箱即用的 Web 界面 […]