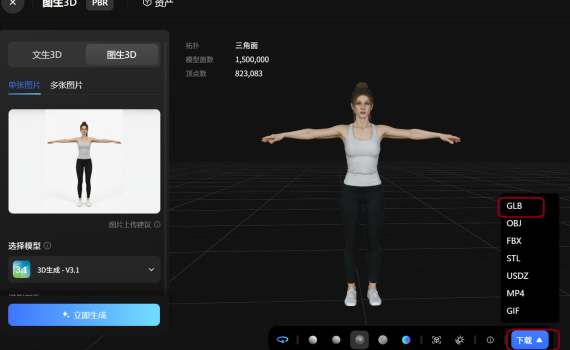
一、前言 想给我自己的桌宠【XiaoMate小美同学】搞一个写实的人物角色,所以趁这个中秋假期来试试看,昨天晚上开始问大模型如何可以用一张人物图片来生成一个3D人物模型,然后看解决方案,下载安装软件Blender(几百兆的文件,莫名其妙的下载了几个钟头),然后今天早上终于把基础流程走通了,但是还存在一些问题,最大的问题是原始生成的模型是有纹理的,但是搞到后面纹理丢失了,还不知道是哪一步的问题。 以下是整个流程,先跟大家分享一下: 二、关于XiaoMate XiaoMate是一个开源的智能桌面宠物应用,支持 2D和3D 模型,可以支持 AI 对话、待办提醒、自动任务、MCP技能调用等丰富功能。 1. 代码仓库 2. 快速开始 本次暂时只提供 Windows 绿色便携包,如果你只是想体验一下XiaoMate的效果,仅需要下载前端包就可以,后端可以先用公有云上的demo版本。 前端可前往 XiaoMate Desktop v2.0.7 发布页 下载;后端请前往 XiaoMate 后端仓库 获取。 两个都是绿色便携包,解压后,点击目录中的 start.bat 即可运行。 3. 注意事项 三、完整流程 步骤一、生成人物照片 既然是用混元3D来生成模型,那我就想是不是用同样是腾讯的模型来生成张图片,于是我就直接打开腾讯混元,然后跟它说:生成一张美女的照片,要求背景空白,姿势是T-pose,适用于在混元3d上生成人物模型 结果混元说:我这边不能直接生成并发送图片 于是我又打开千问,把混元输出的提示词喂给了千问。 完整提示词: 正面全身标准 T-pose 参考图,一位年轻成年女性,虚拟人物,面容清秀,表情中性,眼睛睁开,长发扎成低马尾或丸子头,露出额头、脖子和肩膀;身穿浅灰色紧身运动背心和黑色紧身瑜伽裤,衣服合身但不暴露,脚穿白色运动鞋或赤脚;双臂向两侧水平伸直,与肩同高,手掌朝下,手指自然伸直并微微分开,不握拳;双腿伸直,双脚与肩同宽,脚尖朝前;身体笔直站立,正对镜头;纯白色背景,无任何道具、家具、文字、水印;影棚均匀柔光,轻微接触阴影,超写实,高细节,8k,全身完整入镜,四周留白,不裁剪手臂和脚;适合 3D 建模的正面 T-pose 参考图,非性感,非暴露。 千问给我生成了一个美女,如下图所示。 步骤二、生成人物模型 登录混元3D官网:https://3d.hunyuan.tencent.com/我是混元3D的新注册用户,系统给我送了20次生成次数,也不知道是每天可以20次,还是总共只能白嫖20次。在那里选择“图生3D”,然后将千问生成的美女上传上去,再点下面的“立即生成” 过两分钟后,混元3D就把模型给你生成出来的,只不过脸部的一些细节有失真、僵硬的现象,咱先不管,咱现在要求没那么高。 然后我们选择将生成好的模型下载下来,我选择下载的模型类型是GLB格式的,因为我刚刚下载安装的Blender很干净,原始版本,啥插件也没有,纯粹是图方便、不想走弯路,事实上其他的一些格式也应该是OK的。 步骤三:用Blender清洗混元3D生成的模型 将下载下来的混元3D生成的glb模型import(导入)到 […]
Monthly Archives: September 2026
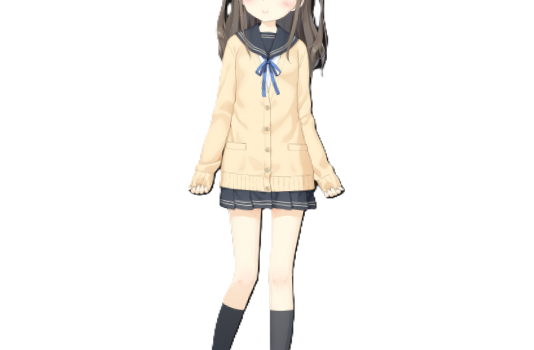
更新周期:2026 年 9 月 26 日 当前版本:v2.0.7 前言 这段时间,XiaoMate 的更新重点只有一个:把桌宠的 3D 能力真正补齐,并让模型切换和动画播放变得稳定。 此前,XiaoMate 已经具备 Live2D 和 VRM 的基础加载能力,但在实际使用中仍然存在一些明显问题:Live2D 与 3D 模型来回切换时容易出现画面残留,播放 VRMA 或 FBX 动画后偶尔会停在 T-pose,模型尺寸和目录配置也缺少统一处理。 经过这几轮重构和修复,现在 XiaoMate 可以在同一个应用中加载并切换: 除了模型能力本身,本次还加入了透明区域点击穿透,将设置界面拆分为独立窗口,并修复了动画缓存、随机播放、默认模型路径和内存增长等问题。 下面是一次完整更新说明。 号外:项目正式更名为 XiaoMate 有朋友提到,Charlotty 这个名字相对偏向女性角色,而 XiaoMate 不限定角色性别:它既可以承载女性角色,也可以承载男性角色或宠物角色,因此项目名称调整为更加中性的 XiaoMate。 改名后的仓库地址如下: “小美同学”仍然保留为桌宠和快捷方式的名称。 快速开始 本次暂时只提供 Windows 绿色便携包: 前端可前往 XiaoMate Desktop v2.0.7 发布页 下载;后端请前往 […]
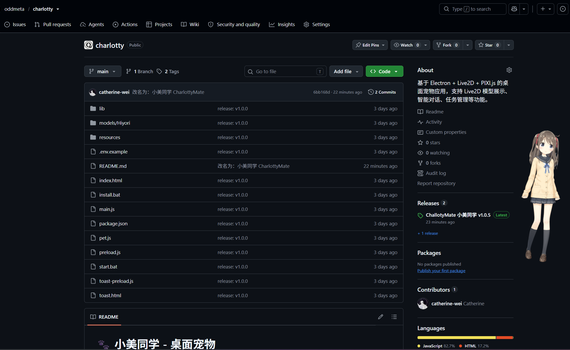
🐾 小美同学 – 桌面宠物 Catherine 同学提出要做一个桌宠,然后现在 TA 终于来了。这个桌宠的完整功能运行需要一个后端(https://github.com/catherine-wei/learning-ai ),目前使用的是部署在 99 元/年 阿里云服务器上的,但是这个阿里云服务器配置(2H+2G+2M)太差,跑一些基于playwright 的功能经常会失败(比如:小奥收藏,自动填报工时等),因此后面会再把后端再打一个包,让所有的服务都本地化运行,所有的数据不出你的电脑。 今天只是开一个头,后面再来更详尽的补充介绍一个这个项目。 基于 Electron + Live2D + PIXI.js 的智能桌面宠物应用,支持 Live2D 模型展示、AI 对话、任务管理、技能调用等丰富功能。 项目信息 ✨ 核心功能 🎭 Live2D 模型展示 🖱️ 窗口交互 💬 AI 智能对话 🎯 圆盘菜单 单击桌宠展开的环形菜单,包含以下功能: 🎵 音效系统 📋 任务管理 提醒待办 定时任务 🔧 MCP 技能系统 ⚙️ 设置系统 网络设置 […]
引言 上周把 Audio8/MOSS-TTS-Nano 集成到 OddTTS 了,测试一下 Audio8/MOSS-TTS-Nano 效果确实好,但 CPU 跑 RTF 3.26(55字合成耗时 27.85 秒),实在没法用于实时场景。 除了这两个模型个,kid 大佬推荐的模型里还差了一个 ZipVoice,123M 参数,Flow Matching 架构,号称”Small and Fast”。 这个周末在家就搞了一下这个模型。 然而,这个 zipvoice 的集成过程并不顺利,甚至可以说一波三折——踩了好多个大坑,从 PyTorch 推理跑不动,到 vocoder 选型错误合成出噪音,再到模型目录验证 bug 导致 voices 为空。这篇文章把这些坑都记录下来,希望能帮到同样想集成 ZipVoice 的同学。 最终方案:sherpa-onnx 推理后端 + ModelScope 模型下载 + 自动 vocoder 下载,pip 安装后一键启动,纯 CPU 运行,RTF 约 1.3-3.0。 […]
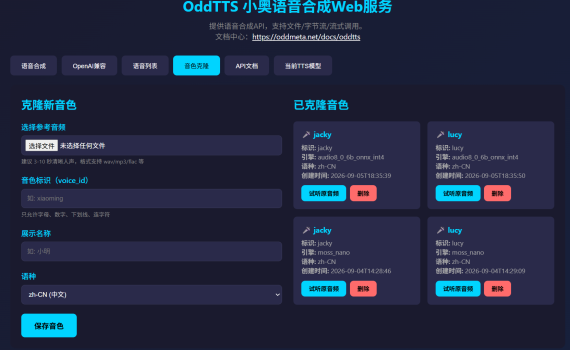
引言 这两个星期,在 大白菜 大佬和 Kid 大佬的提点下,完成了 Audio8 和 MOSS-TTS-Nano 两个轻量级 TTS 引擎的集成工作,也让一直定位于轻量级语音合成的 OddTTS 的引擎矩阵越来越丰富。与此同时刚才这两个引擎都支持音色克隆(zero-shot voice cloning),昨天晚上想起来这摊子事后,就决定把 OddTTS 的音色克隆功能给搞一下,并将这个能力给暴露出来。 今天搞了一天,还算是比较顺利的把音色克隆功能完整实现了,并作为 v2.0 的核心特性发布。 现在,你只需要上传一段 3-10 秒的参考音频,就能在 OddTTS 中注册一个自定义音色,像内置音色一样随时调用——无论是通过 Web 界面还是 OpenAI 兼容 API。 在这个周末,俺终于可以说 OddTTS 完成了从 v1.x 到 v2.0 的跨越。音色克隆功能首批支持 MOSS-TTS-Nano、Audio8 0.1B ONNX INT8、Audio8 0.6B ONNX INT4 三个引擎。后面如果有更多轻量级的 TTS 引擎和模型,我也会持续的将一些适合的引擎一个个的加进 OddTTSk 中,以支持更多引擎。 […]
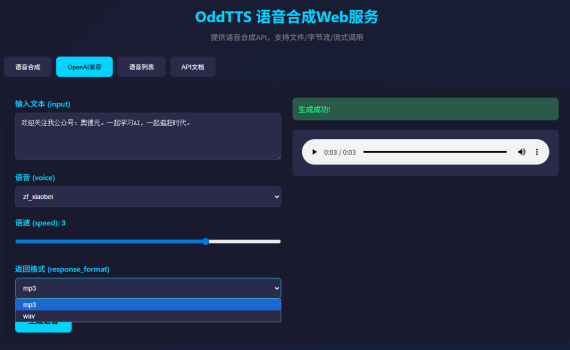
引言 几天前,经 Kid 大佬指点,有两个可以纯 CPU 跑的轻量级TTS模型:MOSS-TTS-Nano 0.1B ONNX(100M)模型 和 ZipVoice Sherpa ONNX(123M)模型。具体可以看上周这篇文章里 Kid 大佬的留言。 今天周末了,我去网上看了一下这两个模型,看上去的样子感觉的确不错,鉴于 100M < 123M,我就先把 MOSS-TTS-Nano先给整合了一下到 OddTTS。 MOSS-TTS-Nano 是 OpenMOSS 团队推出的开源多语言微型语音生成模型。仅 0.1B 参数,无需 GPU 即可在普通 CPU 上实时运行,支持语音克隆、流式推理和 ONNX 加速。—— OpenMOSS 官方介绍 相比于上周集成的 Audio8(0.1B RTF 约 3.26x),MOSS-TTS-Nano 在 CPU 上的推理效率明显更高:在禁用文本规范化的极速模式下,RTF 可达到约 0.5,这意味着它已经能够胜任类似 小落同学 这样的低延迟实时对话场景。同时,它支持近 20 种语言 和 48 […]