版本信息 更新说明 现有机制下,所有启用的模型都会在 OddASR 启动的时候检测模型是否已下载,若未下载会自动开始下载,而部分模型(如:SenseVoice ONNX)在国内下载不稳定,普通的环境经常下载失败,导致普通的、不会github上网的非技术人员在使用 OddASR 的时候体验不佳。 上周用 OddASR 做了一个录音转写的产品:小奥录音,考虑到产品的用户群主要是普通用户,因此,决定默认禁用一些下载不稳定的模型。 但是 OddASR 的所有模型的功能都还是完整的,知道如何稳定下载各模型的技术人员可以自行修改配置文件,将相应的模型启用起来即可。 详细功能修改 版本特性 2-Pass ASR 架构 OddASR 2.x 采用 2-Pass ASR 策略,结合流式识别和离线识别: 核心特性 快速开始 安装 服务启动后: 无需 config.json 配置文件,服务使用内置 DEFAULT_CONFIG 启动。如需自定义,创建 config.json 覆盖需要修改的项即可。切换模型时若配置文件不存在会自动创建。 Python 客户端 OddAsr支持OpenAI兼容接口,推荐使用OpenAI的API接口来调用。 版本历史 v2.x (当前) 系统要求 常见问题 首次运行需要下载模型吗? 是的,首次运行需要下载 ASR 模型。可以通过设置 HuggingFace 镜像加速: […]
Speech Tech
28 posts
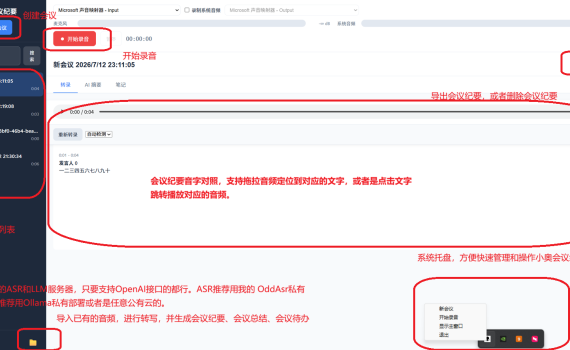
一、前言 前天公司的一位大佬在内部一个大佬群里发了一个某鱼的智能录音卡产品,据宣称该产品某鱼只花了一个星期就做出来了。个人感觉有点不可思议。 再加上前两天原本一直免费的豆包“音频纪要”功能开始收费了,Lucy同学说想自己用opencode做一个音频纪要的功能来接替上去。 我听了后就开始有点手痒痒了,趁这个周末超级台风“巴威”要来,看看能不能在家里vibe coding一下试试。 经过一个周末的努力,我也不知道烧了多少token,反正周六、周日两天我的几个coding plan都提示我上限了。不过感觉基础功能已经差不多了,先放一个版本到 github。 开源的智能会议纪要系统,支持实时录音、AI 转录、智能摘要生成和音字联动功能,基本上我能想到的一些功能都已经支持了。 而且也支持全私有化部署,确保所有数据都只能您自己的电脑上,保护您的隐私。 虽然豆包的音频纪要功能仍然免费可用,但OddMinutes 小奥会议纪要是专门做会议纪要的,可以做到比豆包更专业,可用性、安全性、隐私等方面更强。 当然如果您有一些其他的功能需求、功能建议的话,也欢迎给我提出来,我看看是不是可以加进去。 二、使用步骤 主要有三个外部依赖:ffmpeg: 用于将录制下来的音频、或者是导入的音频转换成mp3格式ASR服务:用于将音频转换成文字LLM服务:用于将会议纪录生成会议纪要、会议总结和会议待办其中ASR服务和LLM服务,对应到小奥会议纪要 Web 界面左下角的配置里的两个配置项。全都支持私有化本地部署。 三、功能特性 四、快速安装 首次运行时,程序会自动初始化数据库并创建用户数据目录。 Windows下会在桌面自动创建两个快捷方式,具体如下图所示: 五、外部服务依赖 主要是两个依赖:一个是ASR服务,另一个是LLM服务。对应到小奥会议纪要 Web 界面左下角的配置里的两个配置项。全都支持私有化本地部署。 1. OddASR 语音识别服务 必需 – 用于音频转录,提供 OpenAI 兼容的 /v1/audio/transcriptions 接口。 安装 OddASR 服务 运行 OddASR 服务 在小奥会议纪要的Web界面左下角配置 OddAsr的地址 2. Ollama / LLM 服务 […]
一、项目背景 OddTTS:一个统一多引擎的 TTS 语音合成 API 封装工具,现已支持 OpenAI TTS API 兼容 OddTTS 诞生于作者的一个实际需求——为项目 「小落同学」 提供文字转语音能力。由于受限于99元/年的阿里云ECS服务器硬件条件,最初只能使用 EdgeTTS,但作者本人的电脑配置尚可(十年前买的老笔记本,呵呵),尝试了多种 TTS 引擎后,决定为这些模型创建一个统一的封装层。 于是,OddTTS 应运而生——一个强大的多引擎文本转语音服务,提供统一的 API 接口和友好的 Web 界面,让你用一套接口就能对接多个主流 TTS 引擎。 二、核心功能 支持多种 TTS 引擎: 我自己目前使用的主要是:EdgeTTS和Kokoro-82M-v1.1-zh这两个模型,分别用在阿里云ECS和我自己的十年前老笔记本上。 注:市面上还有许多其他的轻量级的TTS模型,但是由于我自己的使用场景里,主要的语言是中文,所以我选择的都是必须要支持中文的轻量级模型,不支持的一概忽略。 多种调用方式: 在OddTTS自带的Demo的web上都有演示。 好用的 Web 界面: 基于 Flask 构建的可视化操作界面,支持文本输入、语音选择、参数调节、音频生成与下载,开箱即用。 三、近期更新亮点 API 请求耗时日志 — 现在每个 API 请求都会打印时耗日志,启动时也会显示当前运行的 TTS 引擎名称,方便监控和调试。 模型下载异常修复 — […]
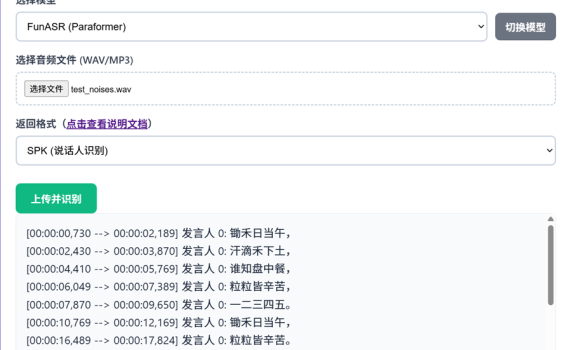
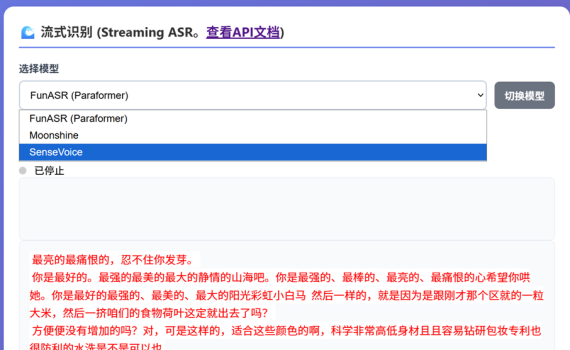
引言 前阵子发现,我五一假期几天搞的小落同学新版本的文章《可用十年前老笔记本纯CPU跑的全套虚拟人方案》被微信判定为违规,一下子打消了我写公众号的积极性,所以这段时间都不太想写公众号。 OddASR 是一个兼容 OpenAI API 的自动语音识别(ASR)服务器,支持离线转录和流式转录。让语音转写更简单。 距离上次发版又过去了几个月,OddASR 陆陆续续发布了一些重要更新。无论是端侧纯 CPU 运行的突破、多音频格式的全面支持,还是前端自由切换模型的灵活体验,每一次更新都为了让语音转写变得更简单、更强大。 昨天,大佬大白菜 反馈了一些问题,我当时在上班没有时间处理,结果他自己直接帮我修复了。 今天我在家也顺便把他帮忙改的代码也合到了主分支,然后顺便也发布了一个新的版本 2.4.6,这里就盘点一下 OddASR 近期的一些更新,顺手把文档也更新了一下(今年一直在忙公司那边的一个智能运维的项目,每天跟产品、测试、需求纠缠不清,包括OddASR、小落同学等项目也都一直没时间搞,更别说是一些文档了)。 一、SenseVoice ONNX 版:端侧 CPU 也能飞 最大的更新莫过于SenseVoice ONNX 版本 的加入,这主要是应对小落同学要在我那个十年前的老笔记本上跑的需求。 借助 sherpa-onnx 框架,SenseVoice 现在可以在纯 CPU 环境下流畅运行,无需 GPU 也能获得出色的识别效果。这对于没有独立显卡的服务器、笔记本乃至边缘设备来说,无疑是个巨大的福音。 功能对应「小落同学」的新版本,特别感谢 大蟑螂 和 大白菜 两位大佬的贡献支持和建议!” SenseVoice 同时支持离线转写和模拟流式输出(基于内置 VAD),成为继 Paraformer、Moonshine 之后的第三大后端引擎。 个人推荐:FunASR > SenseVoice > Moonshine […]
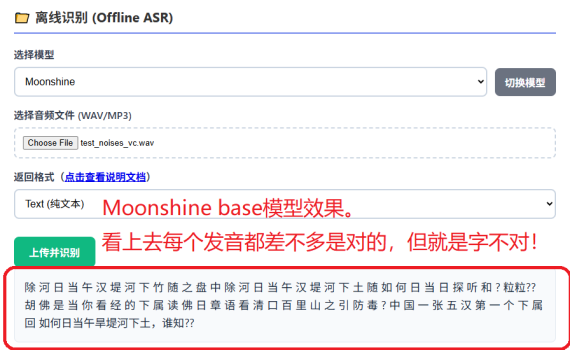
前两天研究了一下Moonshine Voice,当时拿了几个简单的音频文件测试了一下,感觉效果还可以,所以我就开始将其整合到了OddASR项目里。 但是在完成了整合后,再进行测试的时候发现一些比较严重的问题,所以,我又赶紧把我刚刚上传到pypi的OddASR给撤了,然后重新将主力模型改回到paraformer-zh-streaming和paraformer-zh。 当前OddAsr最新版本:v2.1.0,已恢复paraformer模型。 以下是在OddAsr自带的测试界面上分别跑paraformer-zh和moonshine base模型的效果 测试音频 具体的声音情况可以看这个视频: https://mp.weixin.qq.com/s/y4l-YtaUhayV9k9EDatCzw 注:这个视频中并未使用我的OddASR,效果差不是我OddAsr项目的锅。相反,下面我后来有将这个视频中的音频提取出来,专门作为OddAsr的一个测试集,每次测试不同的ASR模型的时候都会来测试一下这种场景。比如:这次的Moonshine base中文模型的测试。 测试效果 测试使用的音频就是上面那个视频里提取出来的音频。 paraformer模型效果 只想用一个字来形容:bravo! moonshine base模型效果 看上去转写出来的每个发音都是对的,但是。。。。这些个字呢。。。。好像就没几个是对的。 总结 唉,如果不是因为我这个用了超过十年的老笔记本CPU不太够用,我也完全不想去折腾一些其他的轻量级的ASR模型。
前言 最近在折腾 OddTTS 项目,涉及语音合成后的处理。发现一个很香的轻量级变声方案——直接用 FFmpeg 就能搞定,不需要复杂的模型部署。 本文记录 FFmpeg 变声的核心方法、性能数据、以及在 OddTTS 项目中的实际应用场景。 先来听听效果 原始声音: 变声: 卡通声: 一、FFmpeg 变声原理解析 1.1 核心滤镜:asetrate + aresample FFmpeg 变声的核心在于两个滤镜的配合: 简单理解:asetrate 相当于把录音速度改了,音调随之变化;aresample 把时长”拉”回来。 1.2 保持原始时长:atempo 上面的方法会导致音频时长变化。如果要保持原时长,需要加 atempo: 原理:asetrate 改变音调会改变时长,atempo 反向调整速度,两者抵消。 二、常用变声效果库 直接套用,无需记公式: 效果 命令 适用场景 男变女 asetrate=44100*1.4,aresample=44100 客服配音 女变男 asetrate=44100*0.7,aresample=44100 角色切换 卡通音 asetrate=44100*2,atempo=0.5,aresample=44100 短视频特效 机器人声 afftfilt=real='hypot(re,im)*0.3':imag='0' 科幻配音 […]
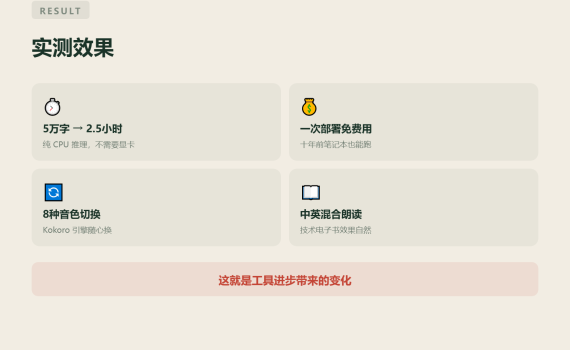
一、先看效果 你有一本 10 万字的技术电子书,想把它变成有声书。不是那种机器感很强的合成音,而是自然流畅的人声。 把文本拖进去,点一下开始,然后去喝杯咖啡。回来的时候,一本完整的有声书已经躺在你的文件夹里了。 这不是科幻,这是我真做出来的功能。 实测效果: 二、什么是 OddTTS? OddTTS 是我之前开源的语音合成 API 封装项目。 两个特点:多引擎、低成本。 多引擎:支持 Kokoro、MeloTTS、Edge TTS、OpenAI TTS 统一调用。 低成本:Kokoro 可以在十年前的老笔记本上跑,纯 CPU 推理,一次部署无限使用。 以前做有声书,要么买云端 API(一本书几十块),要么自己部署大模型(需要显卡)。 现在一台几百块的 CPU 机器就能跑,还免费。 三、用 oh-my-openagent 实现的全流程 这一节讲讲我怎么做这个项目。 3.1 第一步:需求分析 用的 Agent:Metis(预规划分析) 直接跟 oh-my-openagent 说”我想做一个有声书功能”,它会调用 Metis 帮你分析: Metis 分析的结果: 3.2 第二步:制定计划 用的 Agent:Prometheus(任务规划) Prometheus 会制定详细的实现计划: Prometheus […]
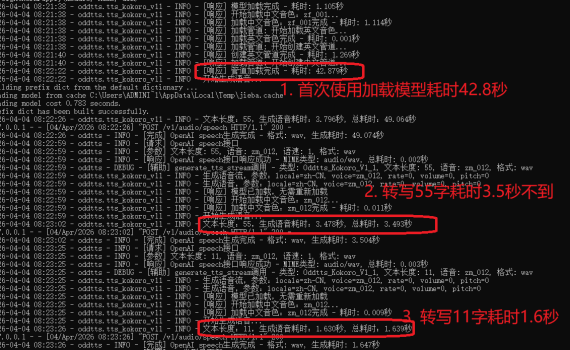
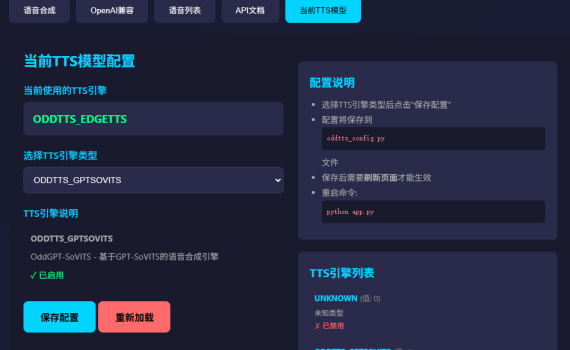
上个星期分别测试了一下两个轻量级的语音合成模型,分别是: 其中Kokoro以更低的CPU要求,可完美达成我的小落同学项目的实时语音交互的需求,因此现在我已经将我的小落同学的主打语音合成在OddTTS上切到了kokoro v1.1。 这里要特别感谢一下一位大佬:路遥。因为前面我以为Kokoro不支持中英混合,所以一开始是准备用MeloTTS的(对CPU要求相对较高),在他的提示下才发现原来Kokoro也可以通过将创建英文和中文两个pipeline来实现中英混合。 以下是一些相关的介绍。 一. 安装 OddTTS 二. 启动 OddTTS 在命令行中输入下面的命令即可启动: 启动后,浏览器打开地址:http://127.0.0.1:9001 启动后,浏览器打开地址:http://your_ip_addr:8080 注: Linux/MacOS: 三. 使用 OddTTS OddTTS支持自定义协议的API,也支持OpenAI兼容接口的API,一般用户建议用OpenAI兼容接口来使用,三行代码搞定语音合成。 其他的API接口可以看OddTTS项目的API接口说明。 四、一些测试数据 1. 合成的语音的效果 合成的语音的效果可以看我之前的测试文章: 正常语速wav格式正常语速mp3格式3倍语速mp3格式 2. 合成的速度 这个是在我的这台十年前的老笔记本上跑的数据: 注:这个3.5秒可认为是首字时延,后面由于合成的速度比播放的速度要快得多的多,所以在长文(需切句子)合成的情况下,实际体验的时延可以做到趋近到500ms以内。 具体如下图所示。 3. 切换不同的TTS模型/引擎 OddTTS有集成了多种不同的TTS模型,包括: OddTTS提供了一个简单的管理、测试界面,在启动了OddTTS后可以在浏览器里打开oddtts,然后动态切换TTS模型/引擎。 五、注意事项 模型下载问题 Kokoro的模型放在huggingface.co上,在国内访问存在问题,解决方案: set HF_ENDPOINT=https://hf-mirror.comset HF_HOME=F:/ai_share/models export HF_ENDPOINT=https://hf-mirror.comexport HF_HOME=/opt/ai_share/models 输出wav正常,输出MP3报错 OddTTS的依赖里有加了ffmpeg,但是如果你机器上原先就有安装过ffmpeg有可能会报错,若是报错了,请再手动安装一下ffmpeg即可。 服务启动失败 语音合成失败 如何切换TTS引擎 输出格式 […]
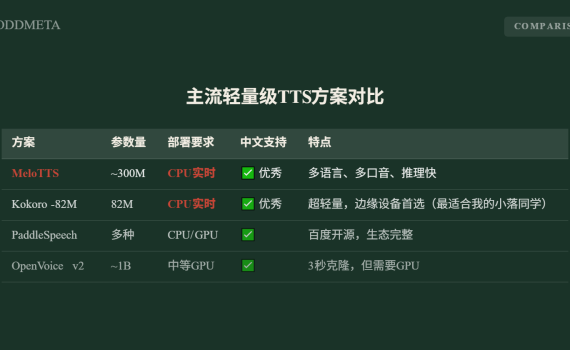
一、前言 你有没有想过,让电脑帮你念一段文章?或者给家里的智能设备添加语音播报功能? 很多人第一次接触语音合成(TTS),想到的是讯飞、百度这些云端API。但仔细一算:调用一次要花钱、网不好会卡顿、隐私数据还要传出去——这对于普通用户来说,门槛实在太高了。 更现实的需求是这样的: 这些场景共同的特点是:设备性能有限、没有显卡、最好能离线使用、还要省钱。 这就是轻量级TTS的用武之地。 二、轻量级TTS方案对比 说方案、对比方案前,先用我实测的一些音频大家听一下效果,感受一下MeloTTS的实际效果。 中英混合:欢迎关注我的公众号:奥德元。一起学习AI,一起追赶时代。Good good study, day day up. 英文-美国口音: text to read 英文-澳大利亚口音: text to read 2.1 主流轻量级TTS方案一览 方案 参数量 部署要求 中文支持 开源协议 特点 MeloTTS ~300M CPU实时 ✅ 优秀 MIT 多语言、多口音、推理快 espeak-ng – 超低资源 一般 GPL 体积超小(4MB),音质机械 Flite – 低资源 ❌ C 轻量但效果一般 VITS […]
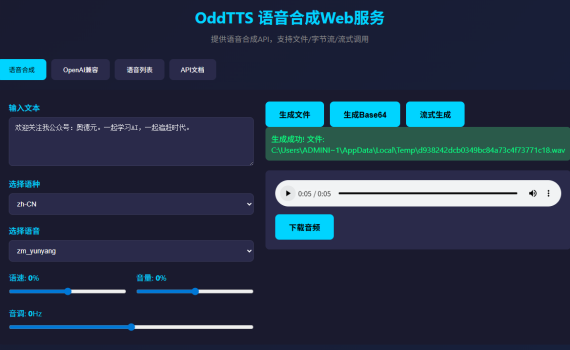
一、前言 前两天针对轻量级TTS引擎Kokoro做了一些测试( https://mp.weixin.qq.com/s/xKBLfAkfImwHrjYIml0KuA ),测试下来发现效果居然挺好的,而且自带8种音色的支持,纯CPU跑,速度还快,测完了我就停不下来了,当时就想把它整合到我的OddTTS项目,今天周末终于有空,于是就简单搞了一下,现在已经在我的小落同学上用上了。 二、主要更新 先看效果 正常语速wav格式 正常语速mp3格式 更新内容 三、如何使用 1. 安装 pip install -i https://pypi.org/simple/ oddtts 2. 启动 oddtts 启动后,浏览器打开地址:http://127.0.0.1:9001 若要允许其他IP访问,请使用以下命令启动服务,将host设置为0.0.0.0,端口也可以改成你自定义的端口。 启动后,浏览器打开地址:http://your_ip_addr:8080 3. API调用示例 以下是一个OddTTS的API调用的示例,建议用OpenAI 兼容接口 四、注意事项 模型下载问题 Kokoro的模型放在huggingface.co上,在国内访问存在问题,解决方案: set HF_ENDPOINT=https://hf-mirror.comset HF_HOME=F:/ai_share/models export HF_ENDPOINT=https://hf-mirror.comexport HF_HOME=/opt/ai_share/models 输出wav正常,输出MP3报错 OddTTS的依赖里有加了ffmpeg,但是如果你机器上原先就有安装过ffmpeg有可能会报错,若是报错了,请再手动安装一下ffmpeg即可。 服务启动失败 语音合成失败 如何切换TTS引擎 输出格式 环境要求